Scrapy框架爬取西刺代理网免费高匿代理的实现代码
分析
需求:
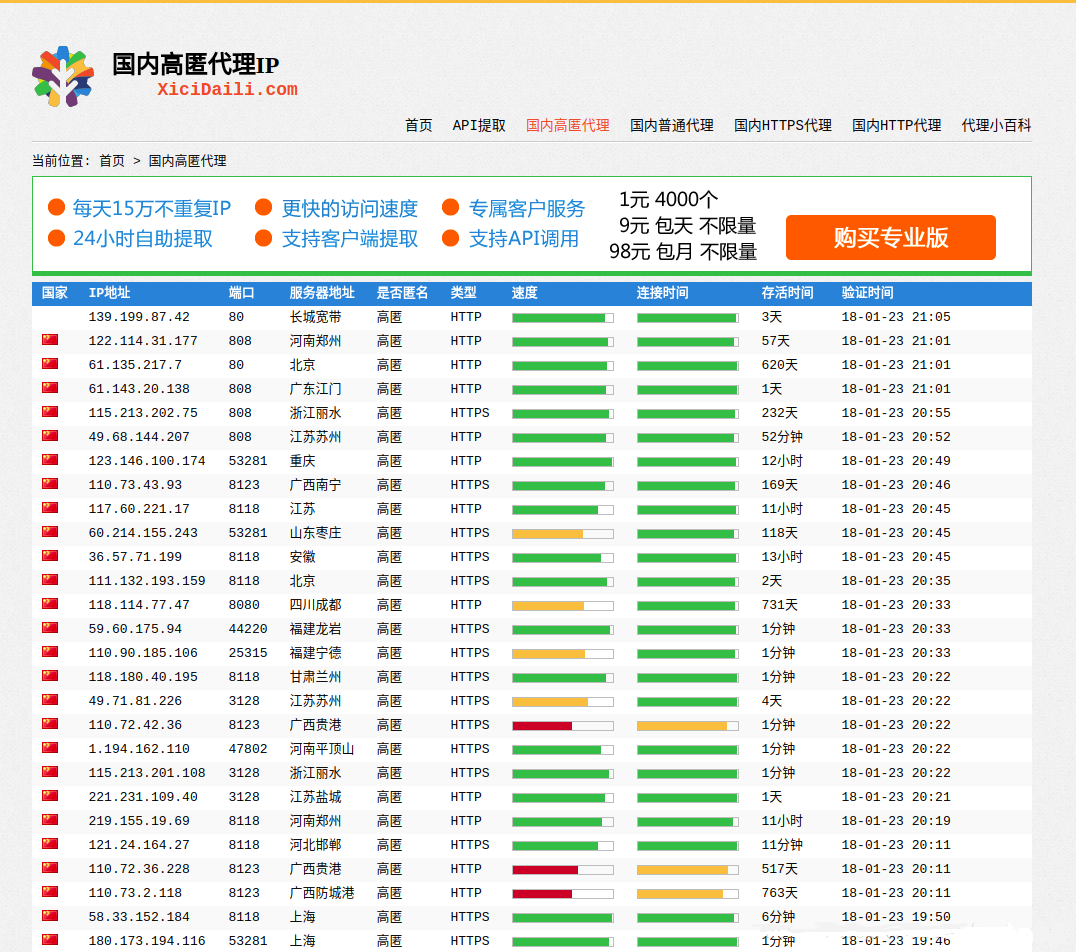
爬取西刺代理网免费高匿代理,并保存到MySQL数据库中。
这里只爬取前10页中的数据。
思路:
- 分析网页结构,确定数据提取规则
- 创建Scrapy项目
- 编写item,定义数据字段
- 编写spider,实现数据抓取
- 编写Pipeline,保存数据到数据库中
- 配置settings.py文件
- 运行爬虫项目
代码实现
items.py
import scrapy
class XicidailiItem(scrapy.Item):
  # 国家
  country=scrapy.Field()
  # IP地址
  ip=scrapy.Field()
  # 端口号
  port=scrapy.Field()
  # 服务器地址
  address=scrapy.Field()
  # 是否匿名
  anonymous=scrapy.Field()
  # 类型
  type=scrapy.Field()
  # 速度
  speed=scrapy.Field()
  # 连接时间
  connect_time=scrapy.Field()
  # 存活时间
  alive_time=scrapy.Field()
  # 验证时间
  verify_time=scrapy.Field()
xicidaili_spider.py
# !/usr/bin/env python
# -*- coding:utf-8 -*-
import scrapy
from myscrapy.items import XicidailiItem
class XicidailiSpider(scrapy.Spider):
  name = 'xicidaili'
  allowed_domains=['www.xicidaili.com']
  # start_urls=['http://www.xicidaili.com/nn/1']
  def start_requests(self):
    urls=[]
    for i in range(1,11):
      urls.append('http://www.xicidaili.com/nn/'+str(i))
    for url in urls:
      yield scrapy.Request(url,callback=self.parse,method='GET')
  def parse(self, response):
    tr_list=response.xpath('//table[@id="ip_list"]/tr')
    for tr in tr_list[1:]: # 过滤掉表头行
      item=XicidailiItem()
      item['country']=tr.xpath('./td[1]/img/@alt').extract_first()
      item['ip']=tr.xpath('./td[2]/text()').extract_first()
      item['port']=tr.xpath('./td[3]/text()').extract_first()
      item['address']=tr.xpath('./td[4]/a/text()').extract_first()
      item['anonymous']=tr.xpath('./td[5]/text()').extract_first()
      item['type']=tr.xpath('./td[6]/text()').extract_first()
      item['speed']=tr.xpath('./td[7]/div/@title').re(r'\d{1,3}\.\d{0,}')[0]
      item['connect_time']=tr.xpath('./td[8]/div/@title').re(r'\d{1,3}\.\d{0,}')[0]
      item['alive_time']=tr.xpath('./td[9]/text()').extract_first()
      item['verify_time']=tr.xpath('./td[10]/text()').extract_first()
      yield item
pipelines.py
class XicidailiPipeline(object):
  """
  西刺代理爬虫 item Pipeline
  create table xicidaili(
    id int primary key auto_increment,
    country varchar(10) not null,
    ip varchar(30) not null,
    port varchar(10) not null,
    address varchar(30) not null,
    anonymous varchar(10) not null,
    type varchar(20) not null,
    speed varchar(10) not null,
    connect_time varchar(20) not null,
    alive_time varchar(20) not null,
    verify_time varchar(20) not null);
  """
  def __init__(self):
    self.connection = pymysql.connect(host='localhost',
                     user='root',
                     password='123456',
                     db='mydb',
                     charset='utf8', # 不能用utf-8
                     cursorclass=pymysql.cursors.DictCursor)
  def process_item(self,item,spider):
    with self.connection.cursor() as cursor:
      sql='insert into xicidaili' \
        '(country,ip,port,address,anonymous,type,speed,connect_time,alive_time,verify_time) values' \
        '(%s,%s,%s,%s,%s,%s,%s,%s,%s,%s);'
      args=(item['country'],item['ip'],item['port'],item['address'],item['anonymous'],item['type'],item['speed'],item['connect_time'],item['alive_time'],item['verify_time'])
      spider.logger.info(args)
      cursor.execute(sql,args)
    self.connection.commit()
  def close_spider(self,spider):
    self.connection.close()
settings.py
ITEM_PIPELINES = {
  'myscrapy.pipelines.XicidailiPipeline': 300,
}
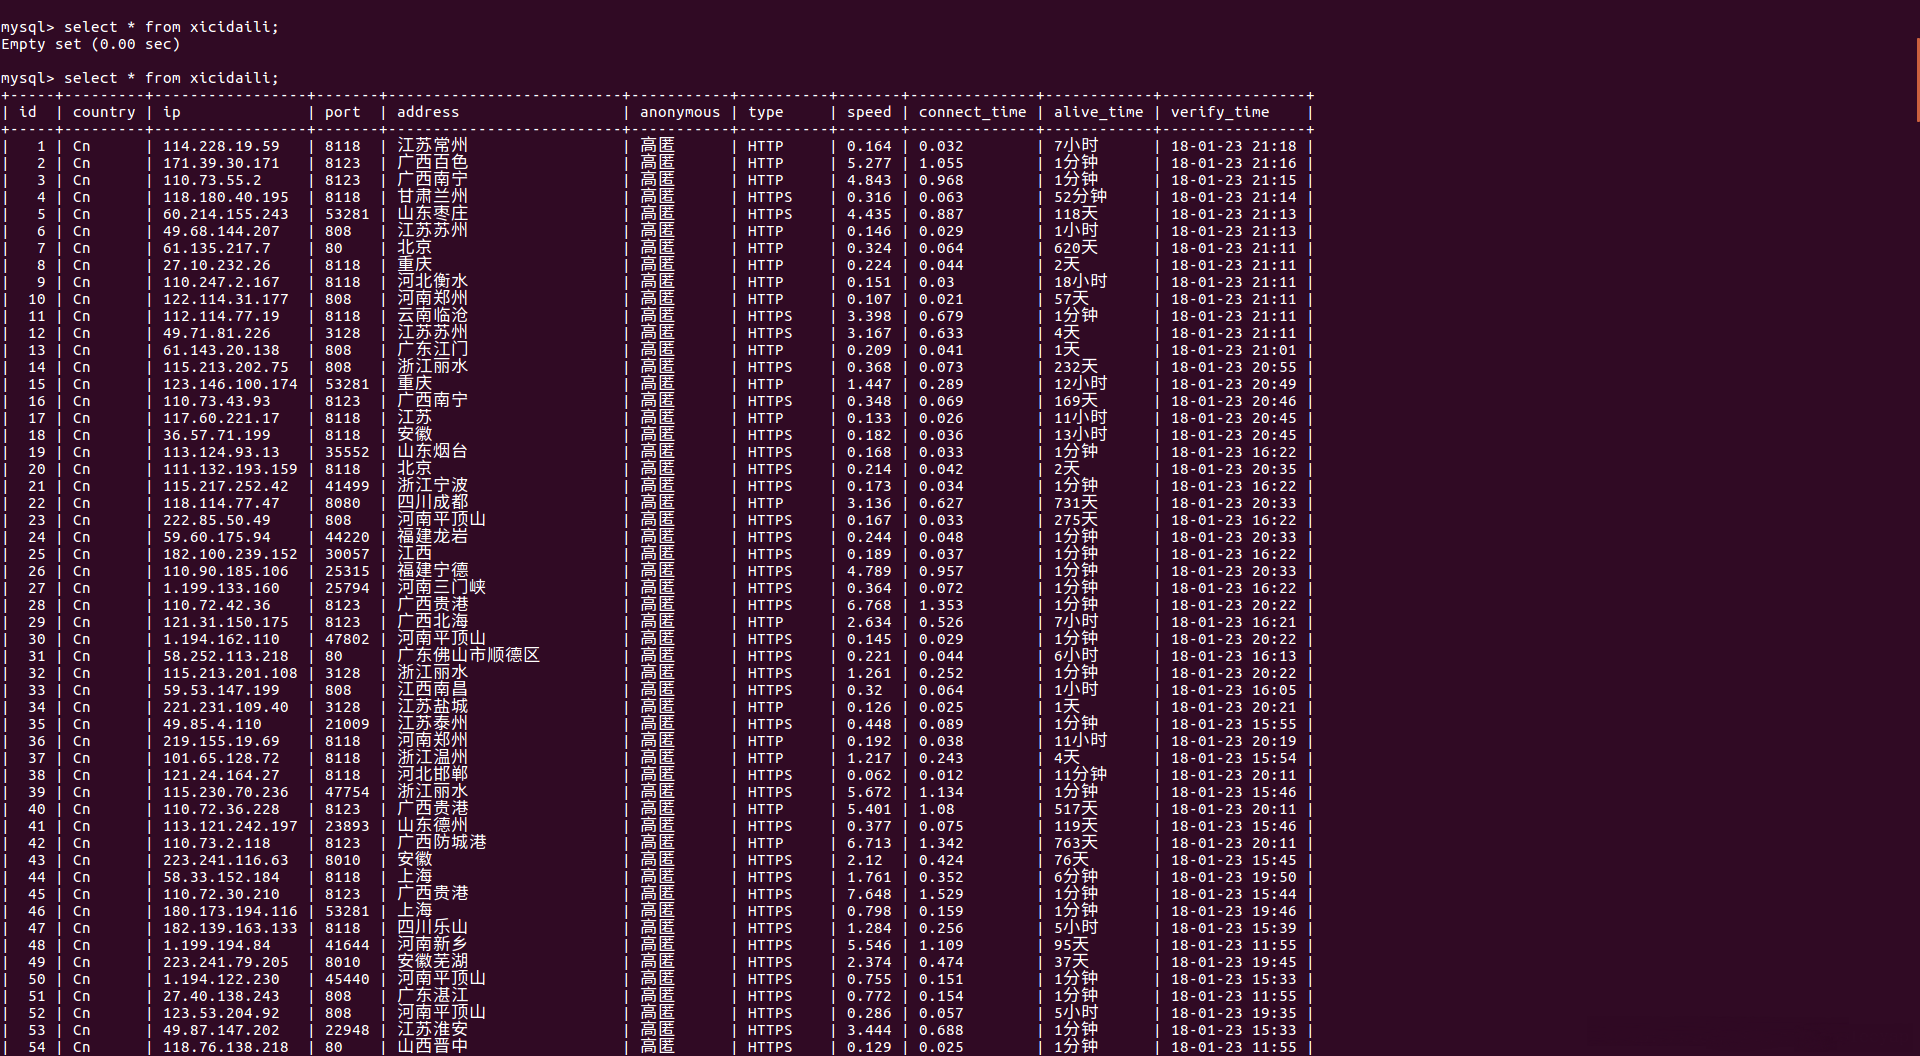
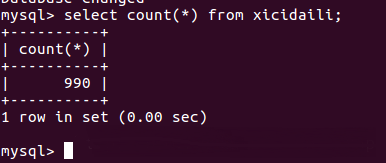
结果
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对【听图阁-专注于Python设计】的支持。如果你想了解更多相关内容请查看下面相关链接