Python正则抓取网易新闻的方法示例
本文实例讲述了Python正则抓取网易新闻的方法。分享给大家供大家参考,具体如下:
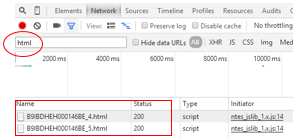
自己写了些关于抓取网易新闻的爬虫,发现其网页源代码与网页的评论根本就对不上,所以,采用了抓包工具得到了其评论的隐藏地址(每个浏览器都有自己的抓包工具,都可以用来分析网站)
如果仔细观察的话就会发现,有一个特殊的,那么这个就是自己想要的了
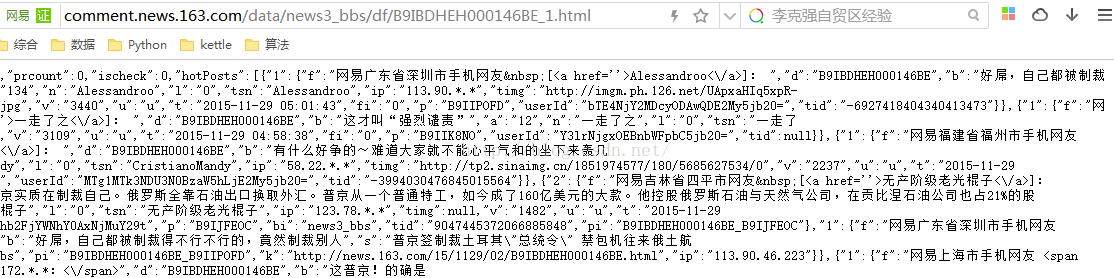
然后打开链接就可以找到相关的评论内容了。(下图为第一页内容)
接下来就是代码了(也照着大神的改改写写了)。
#coding=utf-8
import urllib2
import re
import json
import time
class WY():
  def __init__(self):
    self.headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 5.1) AppleWebKit/534.24 (KHTML, like '}
    self.url='http://comment.news.163.com/data/news3_bbs/df/B9IBDHEH000146BE_1.html'
  def getpage(self,page):
    full_url='http://comment.news.163.com/cache/newlist/news3_bbs/B9IBDHEH000146BE_'+str(page)+'.html'
    return full_url
  def gethtml(self,page):
    try:
      req=urllib2.Request(page,None,self.headers)
      response = urllib2.urlopen(req)
      html = response.read()
      return html
    except urllib2.URLError,e:
      if hasattr(e,'reason'):
        print u"连接失败",e.reason
        return None
  #处理字符串
  def Process(self,data,page):
    if page == 1:
      data=data.replace('var replyData=','')
    else:
      data=data.replace('var newPostList=','')
    reg1=re.compile(" \[<a href=''>")
    data=reg1.sub(' ',data)
    reg2=re.compile('<\\\/a>\]')
    data=reg2.sub('',data)
    reg3=re.compile('<br>')
    data=reg3.sub('',data)
    return data
  #解析json
  def dealJSON(self):
    with open("WY.txt","a") as file:
      file.write('ID'+'|'+'评论'+'|'+'踩'+'|'+'顶'+'\n')
    for i in range(1,12):
      if i == 1:
        data=self.gethtml(self.url)
        data=self.Process(data,i)[:-1]
        value=json.loads(data)
        file=open('WY.txt','a')
        for item in value['hotPosts']:
          try:
            file.write(item['1']['f'].encode('utf-8')+'|')
            file.write(item['1']['b'].encode('utf-8')+'|')
            file.write(item['1']['a'].encode('utf-8')+'|')
            file.write(item['1']['v'].encode('utf-8')+'\n')
          except:
            continue
        file.close()
        print '--正在采集%d/12--'%i
        time.sleep(5)
      else:
        page=self.getpage(i)
        data = self.gethtml(page)
        data = self.Process(data,i)[:-2]
        # print data
        value=json.loads(data)
        # print value
        file=open('WY.txt','a')
        for item in value['newPosts']:
          try:
            file.write(item['1']['f'].encode('utf-8')+'|')
            file.write(item['1']['b'].encode('utf-8')+'|')
            file.write(item['1']['a'].encode('utf-8')+'|')
            file.write(item['1']['v'].encode('utf-8')+'\n')
          except:
            continue
        file.close()
        print '--正在采集%d/12--'%i
        time.sleep(5)
if __name__ == '__main__':
  WY().dealJSON()
以上就是我爬取的代码了。
PS:这里再为大家提供2款非常方便的正则表达式工具供大家参考使用:
JavaScript正则表达式在线测试工具:
http://tools.jb51.net/regex/javascript
正则表达式在线生成工具:
http://tools.jb51.net/regex/create_reg
更多关于Python相关内容可查看本站专题:《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python Socket编程技巧总结》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。