相关文章
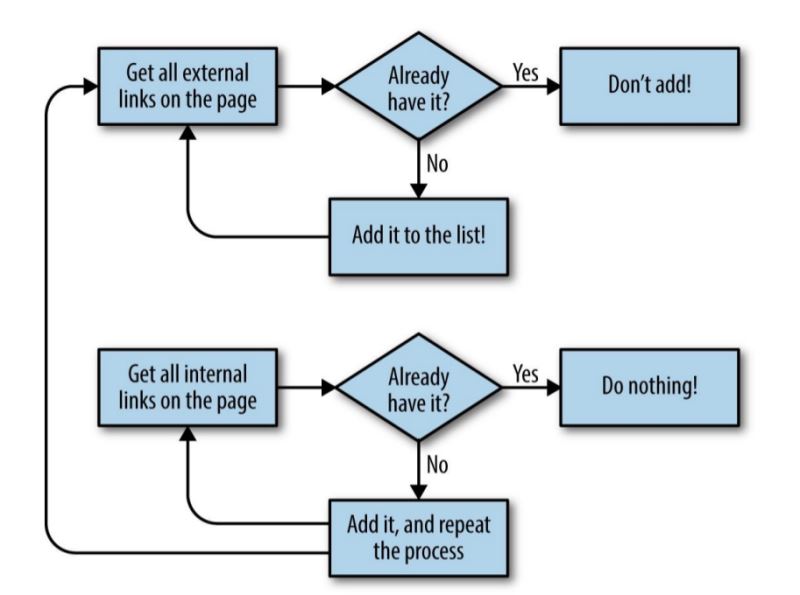
Python爬虫获取整个站点中的所有外部链接代码示例
收集所有外部链接的网站爬虫程序流程图 下例是爬取本站python绘制条形图方法代码详解的实例,大家可以参考下。 完整代码: #! /usr/bin/env python #codi...
Python3网络爬虫之使用User Agent和代理IP隐藏身份
本文介绍了Python3网络爬虫之使用User Agent和代理IP隐藏身份,分享给大家,具体如下: 运行平台:Windows Python版本:Python3.x IDE...

python爬虫入门教程--快速理解HTTP协议(一)
前言 爬虫的基本原理是模拟浏览器进行 HTTP 请求,理解 HTTP 协议是写爬虫的必备基础,招聘网站的爬虫岗位也赫然写着熟练掌握HTTP协议规范,写爬虫还不得不先从HTTP协议开始讲...
Python实现抓取网页并且解析的实例
本文以实例形式讲述了Python实现抓取网页并解析的功能。主要解析问答与百度的首页。分享给大家供大家参考之用。 主要功能代码如下: #!/usr/bin/python #coding...
python抓取网页中的图片示例
复制代码 代码如下:#coding:utf8import reimport urllibdef getHTML(url): page = urllib...