Python抓取百度查询结果的方法

yipeiwu_com7年前Python爬虫

本文实例讲述了Python抓取百度查询结果的方法。分享给大家供大家参考。具体实现方法如下:

#win python 2.7.x
import re,sys,urllib,codecs
xh = urllib.urlopen("http://www.baidu.com/s?q1=123&rn=100").read().decode('utf-8') 
rc = re.compile(r'<td class=f><h3 class="t"><a.*?>(?P<first>.*?)</h3>',re.I)
match = rc.finditer(xh)
rcr = re.compile(r'<[^>]+>',re.I)
f = codecs.open("xiaohei.txt", "w", "utf-8")
for i in rc.finditer(xh):
  ss = i.group(0)
  s1 = rcr.sub('',ss)
  print (s1)
  f.write(s1)
f.close()

希望本文所述对大家的Python程序设计有所帮助。
相关文章

Python tornado队列示例-一个并发web爬虫代码分享

Queue Tornado的tornado.queue模块为基于协程的应用程序实现了一个异步生产者/消费者模式的队列。这与python标准库为多线程环境实现的queue模块类似。 一个协...

python爬虫实例详解

python爬虫实例详解

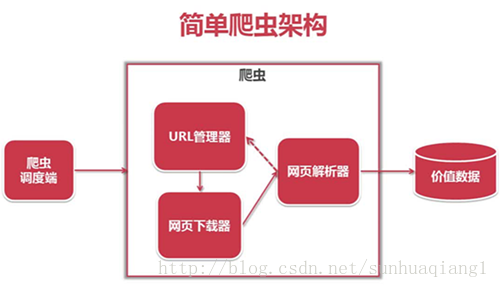
本篇博文主要讲解Python爬虫实例,重点包括爬虫技术架构,组成爬虫的关键模块:URL管理器、HTML下载器和HTML解析器。 爬虫简单架构 程序入口函数(爬虫调度段) #codi...

python requests抓取one推送文字和图片代码实例

这篇文章主要介绍了python requests抓取one推送文字和图片代码实例,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下 req...

Python 爬虫的工具列表大全

网络 通用 urllib -网络库(stdlib)。 requests -网络库。 grab...

解决Python网页爬虫之中文乱码问题

解决Python网页爬虫之中文乱码问题

Python是个好工具,但是也有其固有的一些缺点。最近在学习网页爬虫时就遇到了这样一种问题,中文网站爬取下来的内容往往中文显示乱码。看过我之前博客的同学可能知道,之前爬取的一个学校网页就...