python编写简单爬虫资料汇总
爬虫真是一件有意思的事儿啊,之前写过爬虫,用的是urllib2、BeautifulSoup实现简单爬虫,scrapy也有实现过。最近想更好的学习爬虫,那么就尽可能的做记录吧。这篇博客就我今天的一个学习过程写写吧。
一 正则表达式
正则表达式是一个很强大的工具了,众多的语法规则,我在爬虫中常用的有:
| . | 匹配任意字符(换行符除外) |
| * | 匹配前一个字符0或无限次 |
| ? | 匹配前一个字符0或1次 |
| .* | 贪心算法 |
| .*? | 非贪心算法 |
| (.*?) | 将匹配到的括号中的结果输出 |
| \d | 匹配数字 |
| re.S | 使得.可以匹配换行符 |
常用的方法有:find_all(),search(),sub()
对以上语法方法做以练习,代码见:https://github.com/Ben0825/Crawler/blob/master/re_test.py
二 urllib和urllib2
urllib和urllib2库是学习Python爬虫最基本的库,利用该库,我们可以得到网页的内容,同时,可以结合正则对这些内容提取分析,得到真正想要的结果。
在此将urllib和urllib2结合正则爬取了糗事百科中的作者点赞数内容。
代码见:https://github.com/Ben0825/Crawler/blob/master/qiubai_test.py
三 BeautifulSoup
BeautifulSoup是Python的一个库,最主要的功能是从网页抓取数据,官方介绍是这样的:
Beautiful Soup 提供一些简单的、python 式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。
Beautiful Soup 自动将输入文档转换为 Unicode 编码,输出文档转换为 utf-8 编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup 就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。
Beautiful Soup 已成为和 lxml、html6lib 一样出色的 python 解释器,为用户灵活地提供不同的解析策略或强劲的速度。
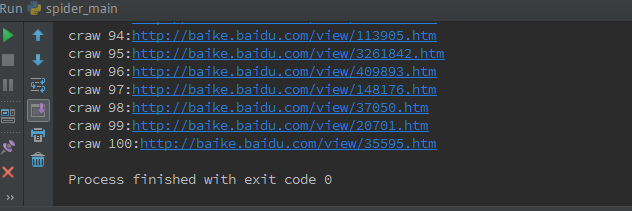
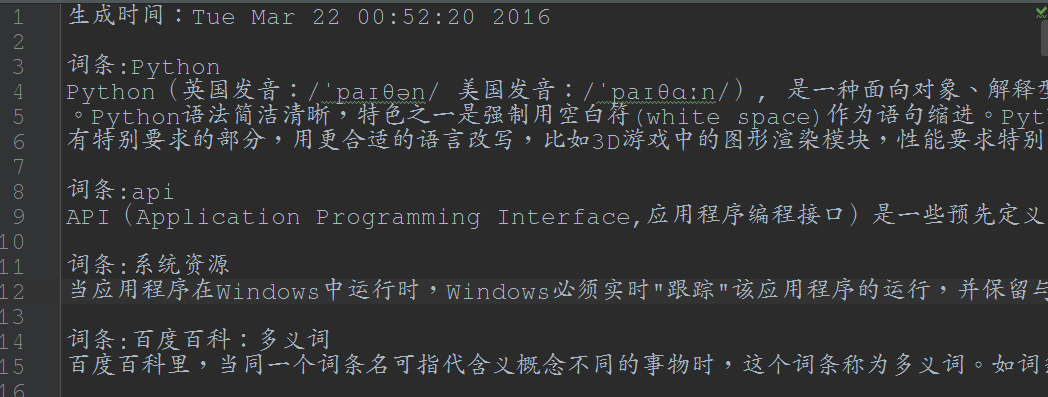
首先:爬取百度百科Python词条下相关的100个页面,爬取的页面值自己设定。
代码详见:https://github.com/Ben0825/Crawler/tree/master/python_baike_Spider
代码运行:
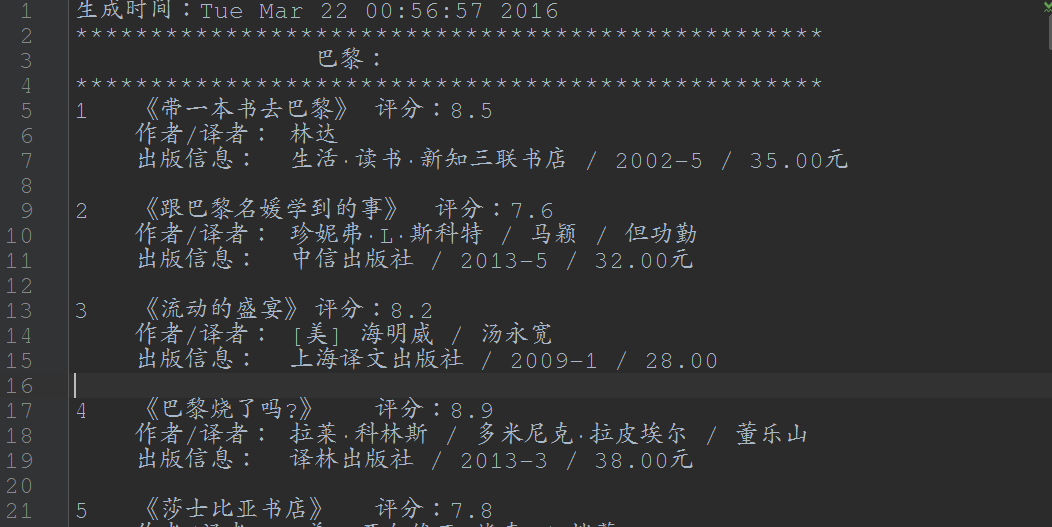
巩固篇,依据豆瓣中图书的标签得到一个书单,同样使用BeautifulSoup。
代码详见:https://github.com/Ben0825/Crawler/blob/master/doubanTag.py
运行结果:
以上就是今天学习的一些内容,爬虫真的很有意思啊,明天继续学scrapy!
