利用Python爬取可用的代理IP
前言
就以最近发现的一个免费代理IP网站为例:http://www.xicidaili.com/nn/。在使用的时候发现很多IP都用不了。
所以用Python写了个脚本,该脚本可以把能用的代理IP检测出来。
脚本如下:
#encoding=utf8
import urllib2
from bs4 import BeautifulSoup
import urllib
import socket

User_Agent = 'Mozilla/5.0 (Windows NT 6.3; WOW64; rv:43.0) Gecko/20100101 Firefox/43.0'
header = {}
header['User-Agent'] = User_Agent

'''
获取所有代理IP地址
'''
def getProxyIp():
 proxy = []
 for i in range(1,2):
  try:
   url = 'http://www.xicidaili.com/nn/'+str(i)
   req = urllib2.Request(url,headers=header)
   res = urllib2.urlopen(req).read()
   soup = BeautifulSoup(res)
   ips = soup.findAll('tr')
   for x in range(1,len(ips)):
    ip = ips[x]
    tds = ip.findAll("td")
    ip_temp = tds[1].contents[0]+"\t"+tds[2].contents[0]
    proxy.append(ip_temp)
  except:
   continue
 return proxy

'''
验证获得的代理IP地址是否可用
'''
def validateIp(proxy):
 url = "http://ip.chinaz.com/getip.aspx"
 f = open("E:\ip.txt","w")
 socket.setdefaulttimeout(3)
 for i in range(0,len(proxy)):
  try:
   ip = proxy[i].strip().split("\t")
   proxy_host = "http://"+ip[0]+":"+ip[1]
   proxy_temp = {"http":proxy_host}
   res = urllib.urlopen(url,proxies=proxy_temp).read()
   f.write(proxy[i]+'\n')
   print proxy[i]
  except Exception,e:
   continue
 f.close()


if __name__ == '__main__':
 proxy = getProxyIp()
 validateIp(proxy)
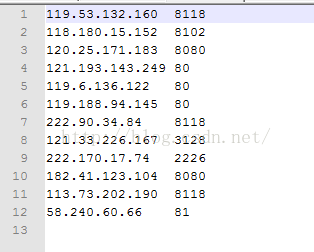
运行成功后,打开E盘下的文件,可以看到如下可用的代理IP地址和端口:
总结
这只是爬取的第一页的IP地址,如有需要,可以多爬取几页。同时,该网站是时时更新的,建议爬取时只爬取前几页的即可。以上就是本文的全部内容,希望对大家学习使用Python能有所帮助。