Python的爬虫框架scrapy用21行代码写一个爬虫
开发说明
开发环境:Pycharm 2017.1(目前最新)
开发框架:Scrapy 1.3.3(目前最新)
目标
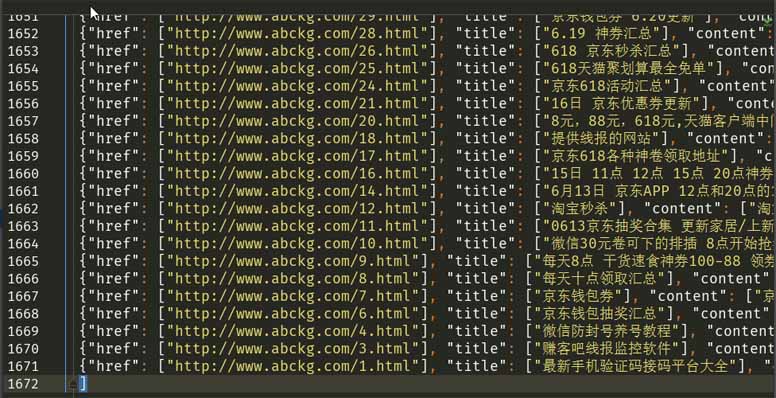
爬取线报网站,并把内容保存到items.json里
页面分析
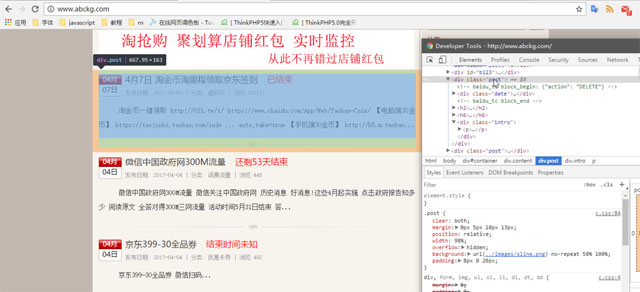
根据上图我们可以发现内容都在类为post这个div里
下面放出post的代码
<div class="post">
<!-- baidu_tc block_begin: {"action": "DELETE"} -->
<div class="date"><span>04月</span><span class="f">07日</span></div><!-- baidu_tc block_end -->
<h2><a href="http://www.abckg.com/193.html" rel="external nofollow" title="4月7日 淘金币淘里程领取京东签到" rel="bookmark" target="_blank">4月7日 淘金币淘里程领取京东签到</a><span>已结束</span></h2>
<h6>发布日期: 2017-04-07 | 分类: <a href="http://www.abckg.com/xunibi" rel="external nofollow" >虚拟币</a> | 浏览:125177
</h6><div class="intro"><p>淘金币一键领取 http://021.tw/t/ https://www.chaidu.com/App/Web/Taobao-Coin/ 【电脑端30金币】 https://taojinbi.taobao.com/inde ... auto_take=true 【手机端30金币】 http://h5.m.taobao...</p></div></div>
实现方法
1、定义items
class DemoItem(scrapy.Item):
 id = scrapy.Field()
 title = scrapy.Field()
 href = scrapy.Field()
 content = scrapy.Field()
2、新建一个爬虫名为test
# -*- coding: utf-8 -*-
import scrapy
from demo.items import DemoItem
from scrapy.http import Request
class TestSpider(scrapy.Spider):
 #定义爬虫的名字和需要爬取的网址
 name = "test"
 allowed_domains = ["www.abckg.com"]
 start_urls = ['http://www.abckg.com/']
 def parse(self, response):
 for resp in response.css('.post'):
  #实例化item
  item = DemoItem()
  #把获取到的内容保存到item内
  item['href'] = resp.css('h2 a::attr(href)').extract()
  item['title'] = resp.css('h2 a::text').extract()
  item['content'] = resp.css('.intro p::text').extract()
  yield item

 #下面是多页面的爬取方法
 urls = response.css('.pageinfo a::attr(href)').extract()
 for url in urls:
  yield Request(url, callback=self.parse)
 categorys = response.css('.menu li a::attr(href)').extract()
 for ct in categorys:
  yield Request(ct, callback=self.parse)
3、修改settings.py,添加以下代码
FEED_EXPORT_ENCODING = 'utf-8'
#运行
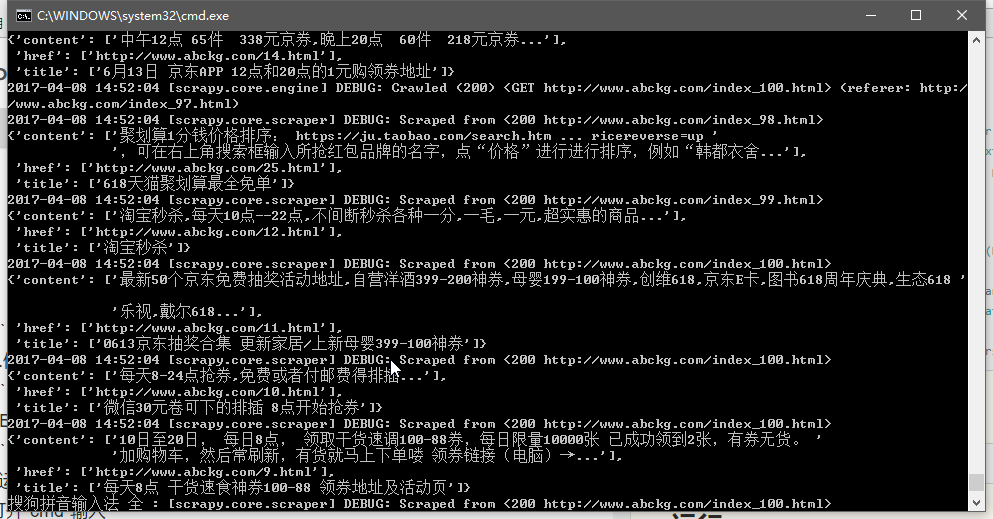
打开cmd输入
scrapy crawl test -o items.json
已知bug
如果多次运行该爬虫,不会覆盖原有的内容,而是追加数据(好像是scrapy的bug)
可拓展内容
1、定时运行爬虫,当检查到网站更新时获取新数据并发邮件通知
2、检测数据是否重复
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者使用python能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对【听图阁-专注于Python设计】的支持。