相关文章
Python爬虫实例爬取网站搞笑段子
众所周知,python是写爬虫的利器,今天作者用python写一个小爬虫爬下一个段子网站的众多段子。 目标段子网站为“http://ishuo.cn/”,我们先分析其下段子的所在子页的u...
Python3简单爬虫抓取网页图片代码实例
现在网上有很多python2写的爬虫抓取网页图片的实例,但不适用新手(新手都使用python3环境,不兼容python2), 所以我用Python3的语法写了一个简单抓取网页图片的实例...
Python3直接爬取图片URL并保存示例
有时候我们会需要从网络上爬取一些图片,来满足我们形形色色直至不可描述的需求。 一个典型的简单爬虫项目步骤包括两步:获取网页地址和提取保存数据。 这里是一个简单的从图片url收集图片的例子...
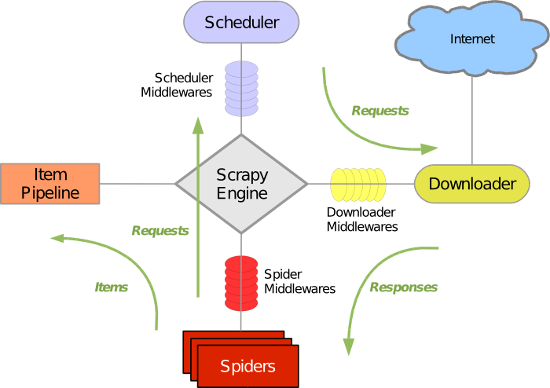
Python的爬虫程序编写框架Scrapy入门学习教程
1. Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。 其最初是为了页面抓取 (更...
python爬虫的一个常见简单js反爬详解
前言 我们在写爬虫是遇到最多的应该就是js反爬了,今天分享一个比较常见的js反爬,这个我已经在多个网站上见到过了。 我把js反爬分为参数由js加密生成和js生成cookie等来操作浏览器...