Python实现爬取百度贴吧帖子所有楼层图片的爬虫示例
本文实例讲述了Python实现爬取百度贴吧帖子所有楼层图片的爬虫。分享给大家供大家参考,具体如下:
下载百度贴吧帖子图片,好好看
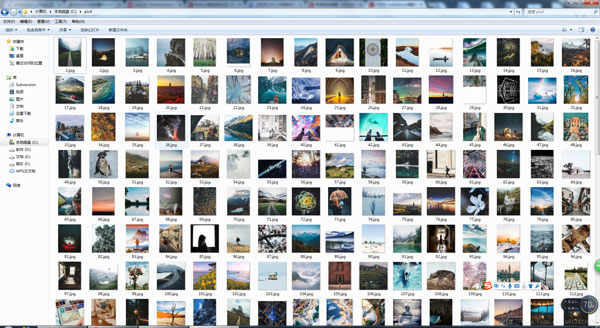
python2.7版本:
#coding=utf-8
import re
import requests
import urllib
from bs4 import BeautifulSoup
import time
time1=time.time()
def getHtml(url):
  page = requests.get(url)
  html =page.text
  return html
def getImg(html):
  soup = BeautifulSoup(html, 'html.parser')
  img_info = soup.find_all('img', class_='BDE_Image')
  global index
  for index,img in enumerate(img_info,index+1):
    print ("正在下载第{}张图片".format(index))
    urllib.urlretrieve(img.get("src"),'C:/pic4/%s.jpg' % index)
def getMaxPage(url):
  html = getHtml(url)
  reg = re.compile(r'max-page="(\d+)"')
  page = re.findall(reg,html)
  page = int(page[0])
  return page
if __name__=='__main__':
  url  = "https://tieba.baidu.com/p/5113603072"
  page = getMaxPage(url)
  index = 0
  for i in range(1,page):
    url = "%s%s" % ("https://tieba.baidu.com/p/5113603072?pn=",str(i))
    html = getHtml(url)
    getImg(html)
  print ("OK!All DownLoad!")
  time2=time.time()
  print u'总共耗时:' + str(time2 - time1) + 's'
PS:这里再为大家提供2款非常方便的正则表达式工具供大家参考使用:
JavaScript正则表达式在线测试工具:
http://tools.jb51.net/regex/javascript
正则表达式在线生成工具:
http://tools.jb51.net/regex/create_reg
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。