Python视频爬虫实现下载头条视频功能示例
本文实例讲述了Python视频爬虫实现下载头条视频功能。分享给大家供大家参考,具体如下:
一、需求分析
抓取头条短视频
思路:
分析网页源码,查找解析出视频资源url(查看源代码,搜mp4)
对该url发起请求,返回二进制数据
将二进制数据保存为视频格式
视频链接:
http://video.eastday.com/a/170612170956054127565.html
二、代码实现
# encoding: utf-8
import sys
reload(sys)
sys.setdefaultencoding('utf-8')
import requests
import re
import time
time1=time.time()
main_url = 'http://video.eastday.com/a/170612170956054127565.html'
resp = requests.get(main_url)
#没有这行,打印的结果中文是乱码
resp.encoding = 'utf-8'
html = resp.text
link = re.findall(r'var mp4 = "(.*?)";', html)[0]
link = 'http:'+link
dest_resp = requests.get(link)
#视频是二进制数据流,content就是为了获取二进制数据的方法
data = dest_resp.content
#保存数据的路径及文件名
path = u'C:/赵丽颖.mp4'
f = open(path, 'wb')
f.write(data)
f.close()
time2 = time.time()
print u'ok,下载完成!'
print u'总共耗时:' + str(time2 - time1) + 's
"D:\Program Files\Python27\python.exe" D:/PycharmProjects/learn2017/testwechat.py
ok,下载完成!
总共耗时:3.20499992371s
Process finished with exit code 0
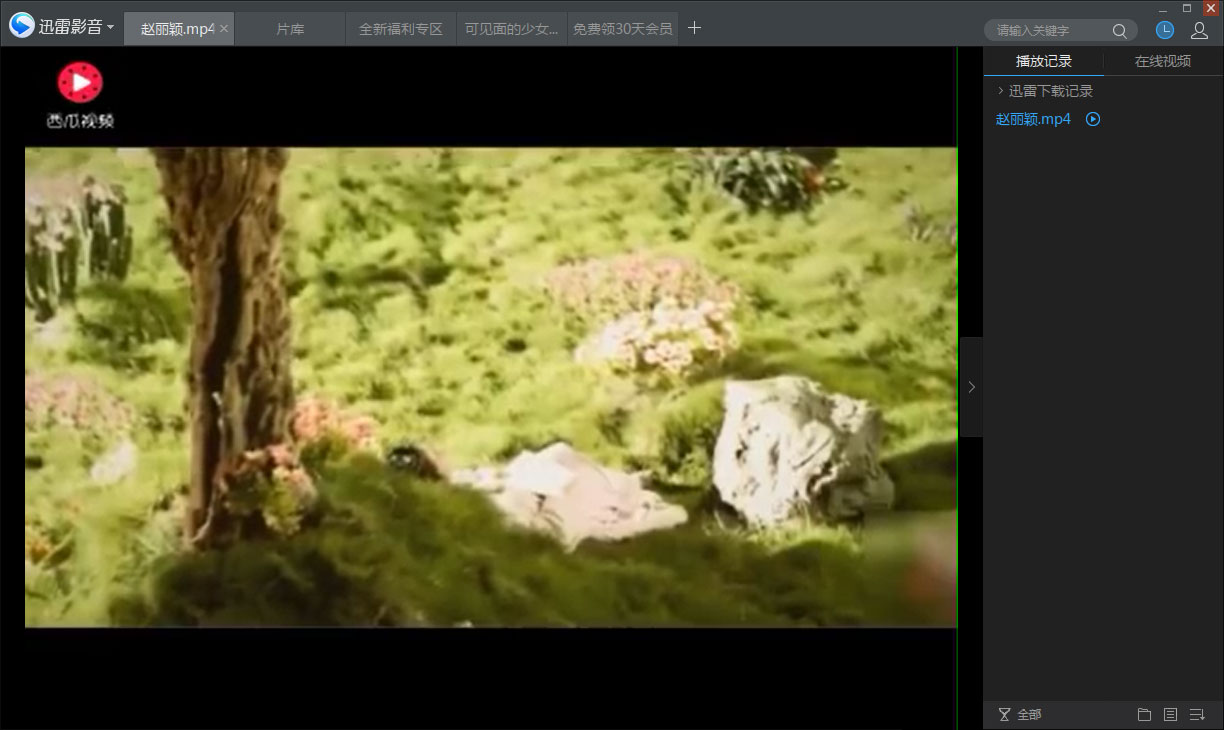
成功下载可以播放~
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。