Python3.x爬虫下载网页图片的实例讲解
一、选取网址进行爬虫
本次我们选取pixabay图片网站
url=https://pixabay.com/
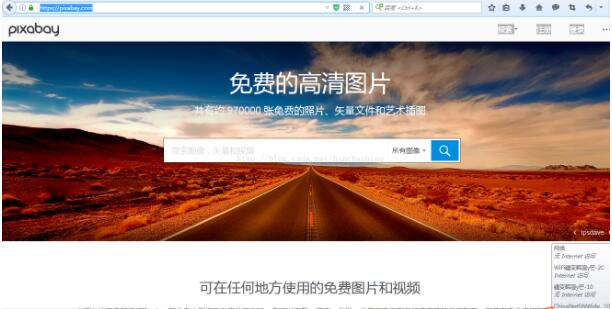
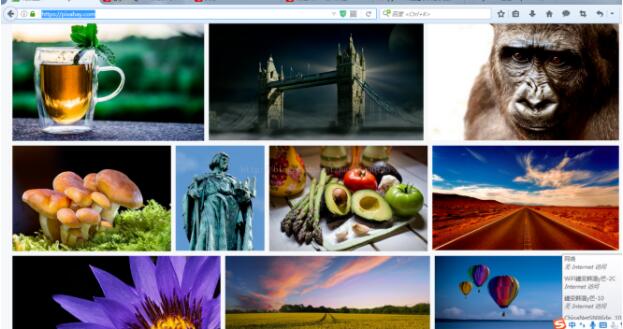
二、选择图片右键选择查看元素来寻找图片链接的规则
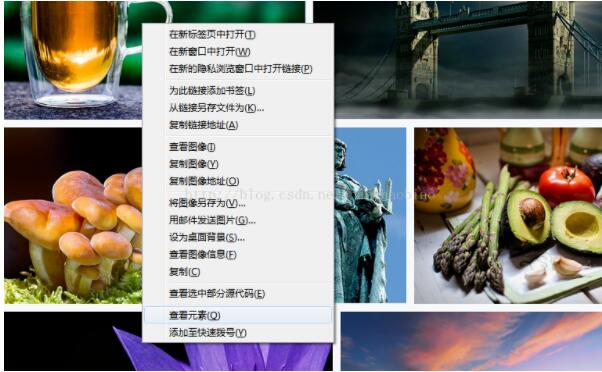
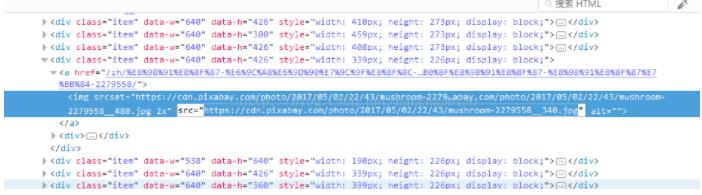
通过查看多个图片路径我们发现取src路径都含有 https://cdn.pixabay.com/photo/ 公共部分且图片格式都为.jpg 因此正则表达式为
re.compile(r'^https://cdn.pixabay.com/photo/.*?jpg$')
通过以上的分析我们可以开始写程序了
#-*- coding:utf-8 -*-
import re
import requests
import os
from bs4 import BeautifulSoup

url = 'https://pixabay.com/'
html = requests.get(url).text #获取网页内容
print(html)
# 这里由于有些图片可能存在网址打不开的情况,加个5秒超时控制。
#data-objurl="http://pic38.nipic.com/20140218/17995031_091821599000_2.jpg"获取这种类型链接
soup = BeautifulSoup(html,'html.parser',from_encoding='utf-8')
#^abc.*?qwe$
pic_url = soup.find_all('img',src=re.compile(r'^https://cdn.pixabay.com/photo/.*?jpg$'))
#pic_url = pic_node.get_text()
#pic_url = re.findall('"https://cdn.pixabay.com/photo/""(.*?)",',html,re.S)
print(pic_url)
i = 0
#判断image文件夹是否存在,不存在则创建
if not os.path.exists('image'):
 os.makedirs('image')
for url in pic_url:
 img = url['src']
 try:
 pic = requests.get(img,timeout=5) #超时异常判断 5秒超时
 except requests.exceptions.ConnectionError:
 print('当前图片无法下载')
 continue
 file_name = "image/"+str(i)+".jpg" #拼接图片名
 print(file_name)
 #将图片存入本地
 fp = open(file_name,'wb')
 fp.write(pic.content) #写入图片
 fp.close()
 i+=1
代码是不是很简单呢 如果你想修改地址 取爬取别的网站 请注意分析下载图片路径的共性 并设计合理的正则表达式,否则是无法获取到图片路径的
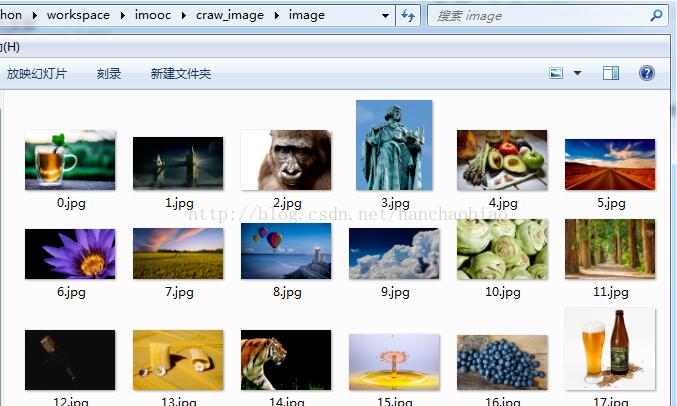
执行过程截图:
以上这篇Python3.x爬虫下载网页图片的实例讲解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。