python爬虫简单的添加代理进行访问的实现代码
在使用python对网页进行多次快速爬取的时候,访问次数过于频繁,服务器不会考虑User-Agent的信息,会直接把你视为爬虫,从而过滤掉,拒绝你的访问,在这种时候就需要设置代理,我们可以给proxies属性设置一个代理的IP地址,代码如下:
 import requests
 from lxml import etree
 url = "https://www.ip.cn"
 headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.102 Safari/537.36 OPR/57.0.3098.116", }
 pro = {
 # 'https': 'https://118.122.92.252:37901', #四川省成都市 电信
 'https': 'https://27.17.45.90:43411', #湖北省武汉市 电信
 }
 try:
 response = requests.get(url, headers=headers, proxies=pro)
 html_str = response.content.decode()
 # print(html_str)
 html = etree.HTML(html_str)
 message = html.xpath("//div[@class='well']//p/text()")
 ip = html.xpath("//div[@class='well']//p/code/text()")
 eng = html.xpath("//div[@class='well']/p/text()")
 print(message[0]+ip[0])
 print(message[1]+ip[1])
 print(eng[2])
 except requests.exceptions.ProxyError as e:
 print("当前代理异常")
 except:
 print("当前请求异常")
在上面的代码中,调用requests库,对一个IP地址查询网页进行访问,随后使用lxml库的xpath对网页进行分析提取,返回用户访问此网页时自己的IP地址,如果代理设置成功,则会返回你的信息和IP地址,如下:
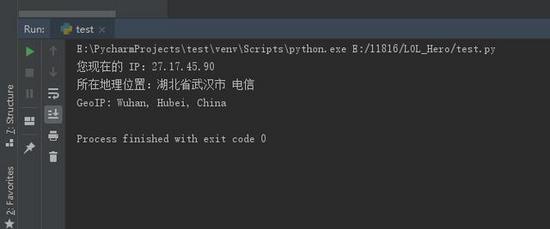
如果代理失败则会返回异常,在代码中使用了捕获异常,则会返回设置的提示信息,"当前代理异常",如果不是代理的错误则是"当前请求异常"
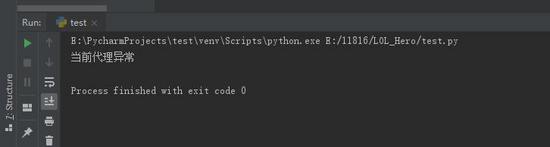
PS:免费的代理不是很稳定,在确认代码无误后,如果仍然返回异常,可尝试更换代理IP...
总结
以上所述是小编给大家介绍的python爬虫简单的添加代理进行访问的实现代码,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!