Python爬虫学习之获取指定网页源码
本文实例为大家分享了Python获取指定网页源码的具体代码,供大家参考,具体内容如下
1、任务简介
前段时间一直在学习Python基础知识,故未更新博客,近段时间学习了一些关于爬虫的知识,我会分为多篇博客对所学知识进行更新,今天分享的是获取指定网页源码的方法,只有将网页源码抓取下来才能从中提取我们需要的数据。
2、任务代码
Python获取指定网页源码的方法较为简单,我在Java中使用了38行代码才获取了网页源码(大概是学艺不精),而Python中只用了6行就达到了效果。
Python中获取网页源码最简单的方法就是使用urllib包,具体代码如下:
import urllib.request    #导入urllib.request库
b = str(input("请输入:"))  #提示用户输入信息,并强制类型转换为字符串型
a = urllib.request.urlopen(b)#打开指定网址
html = a.read()       #读取网页源码
html = html.decode("utf-8") #解码为unicode码
print(html)         #打印网页源码
我输入的网址是我博客主页的网址https://blog.csdn.net/lsylsy726
运行结果如下:
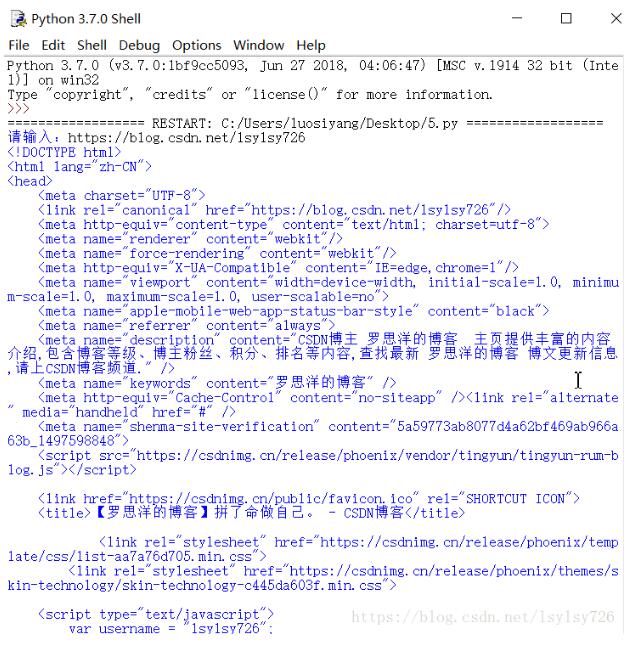
3、总结
这篇博客介绍的方法较为简单,其实有的网站会“反爬虫”,这时就需要我们使用User-Agent或者代理,这些东西都会在后面的博客中进行更新,我预计在后面博客中更新“读取CSDN博客访问量的小程序”和“有道翻译小程序”及其他更难一些的知识,由于刚开始学习爬虫,水平有限,请大家多多包涵。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。