Python使用Beautiful Soup爬取豆瓣音乐排行榜过程解析
前言
要想学好爬虫,必须把基础打扎实,之前发布了两篇文章,分别是使用XPATH和requests爬取网页,今天的文章是学习Beautiful Soup并通过一个例子来实现如何使用Beautiful Soup爬取网页。
什么是Beautiful Soup
- Beautiful Soup是一款高效的Python网页解析分析工具,可以用于解析HTL和XML文件并从中提取数据。
- Beautiful Soup输入文件的默认编码是Unicode,输出文件的编码是UTF-8。
- Beautiful Soup具有将输入文件自动补全的功能,如果输入的HTML文件的title标签没有闭合,则在输出的文件中会自动补全</title>,并且还可以将格式混乱的输入文件按照标准的缩进格式输出。
Beautiful Soup要和其他的解析器搭配使用,例如Python标准库中的HTML解析器和其他第三方的lxml解析器,由于lxml解析器速度快、容错能力强,因此一般和Beautiful Soup搭配使用。
初始化Beautiful Soup对象的代码:
html =
'''
<html><title>Hello Beautiful Soup</title><p>Hello</p></html>
'''
soup = BeautifulSoup(html,'lxml')
只需把第二个参数写成”lxml”即可使用lxml解析器初始化Beautiful Soup对象。
Beautiful Soup提供了三种选择器用去爬取节点中的数据,分别是节点选择器、方法选择器和CSS选择器。下面分别介绍着三个选择器的用法。
节点选择器:
HTML网页有title、p、a、head、tr、td等节点。通过Beautiful Soup对象+”.”+节点即可直接访问到节点。 Beautiful Soup对象+”.”+节点+”.”+string即可提取到节点的文本信息。
| 用法 | 描述 |
|---|---|
| soup.title | 选择第一个title节点 |
| soup.title.string | 提取第一个title节点的文本信息 |
| soup.title.attrs | 获取第一个title节点的所有属性,返回的结果的词典。 如果有class属性,则class属性返回的是list,class属性之间以空格当做分隔符 |
| soup.p.contents | 获取第一个p节点的所有直接子节点。 该方法返回的是第一个p节点中包含的所有直接子字节点和文本, 不包含孙节点,两个节点之间的文本也当做是一个节点返回。 返回的结果是列表 |
| soup.p.children | 返回第一个p节点的所有直接子节点,返回的结果是list_iterator对象 |
| soup.p.descendants | 获取第一个p节点的所有子孙节点 |
| soup.a.parent | 获取第一个a节点的父节点 |
| soup.a.parents | 获取第一个a节点的所有祖先节点 |
| soup.p.next_siblings | 获取第一个p节点的下一个兄弟节点 |
| soup.p.previous_siblings | 获取第一个p节点的上一个兄弟节点 |
方法选择器:
根据传入的参数查找符合条件的节点。 下面是方法选择器提供的方法:
| 方法 | 描述 |
|---|---|
| find_all(name,attrs,recursive,text,**kwargs) | 根据传入参数查找所有符合条件的节点, name是节点名,attrs属性值,text文本内容等。 text参数可以是字符串,也可以是正则表达式: soup.find_all(text=re.compile(‘test')) |
| find(name,attrs,recursive,text,**kwargs) | 返回第一个符合条件的节点 |
| find_parents() | 返回所有祖先节点 |
| find_parent() | 返回父节点 |
| find_next_siblings() | 往后查找,所有兄弟节点 |
| find_next_sibling() | 往后查找,返回第一个兄弟节点 |
| find_previous_siblings() | 往前查找,返回所有兄弟节点 |
| find_previous_sibling() | 往前查找,返回第一个兄弟节点 |
在使用上面的方法时,如果参数中有Python的关键字,则需要在参数下面加一个下划线,例如下面的代码,class是Python的关键字,必须在class后加下划线class_=”title_class”:
from bs4 import BeautifulSoup
html = '''
<html>
  <body>
    <title id="title_id" class="title_class" name="title name">Test BeautifulSoup</title>
    <p>
      <a href = "./test_beautifulsoup.html">test beautifulsoup link<a>

    </p>
    <ul>
      <li class="animal">cat</li>
      <li class="animal">dog</li>
    </ul>
  </body>
</html>
'''
soup = BeautifulSoup(html,'lxml')
print(soup.find_all(name='title',class_='title_class'))
CSS选择器:
BeautifulSoup还支持获取css元素,例如ul、div、li等元素。CSS选择器主要提供select()方法获取符合条件的节点(Tag对象),然后通过节点的get_text()方法和text属性可以获取该节点的文本值。
select方法还可以根据css的样式规则选择相应的节点:
from bs4 import BeautifulSoup

html = '''
<html>
  <body>
    <title id="title_id" class="title_class" name="title name">Test BeautifulSoup</title>
    <p>
      <a href = "./test_beautifulsoup.html">test beautifulsoup link<a>

    </p>
    <ul class="animal" id="aninal_id">
      <li class="cat">cat</li>
      <li class="animal dog">dog</li>
    </ul>
    <ul class="fruit" id = "fruit_id">
      <li class="apple">apple</li>
      <li class="banana">banana</li>
    </ul>
  </body>
</html>
'''
soup = BeautifulSoup(html,'lxml')
print('获取id为title_的所有节点')
print(soup.select('#title_id'))
print('获取class为title_的所有节点')
print(soup.select('.title_class'))
print('获取所有ul节点下面的所有li节点')
print(soup.select('ul li'))
print('获取所有class为fruit节点下的所有li节点')
print(soup.select('.fruit li'))
print('获取所有class为fruit节点下的第一个li节点的文本值')
print(soup.select('.fruit li')[0].string)
print('获取所有class为fruit节点下的第一个li节点的文本值')
print(soup.select('.fruit li')[0].get_text())
print('获取所有class为fruit节点下的第一个li节点的class属性值,注意class属性返回的是list列表,属性之间用空格分隔')
print(soup.select('.fruit li')[0].attrs['class'])
print(soup.select('.animal li')[1].attrs['class'])
print('循环迭代所有ul下面的所有li节点的文本值')
for li in soup.select('ul li'):
  print(li.text)
下面使用Beautiful Soup爬取豆瓣音乐排行榜。 在浏览器中打开豆瓣音乐排行榜,打开浏览器,输入网址:https://music.douban.com/chart,我们要抓取的是每首歌曲的排名、歌曲名、演唱者、播放次数、上榜天数等数据。
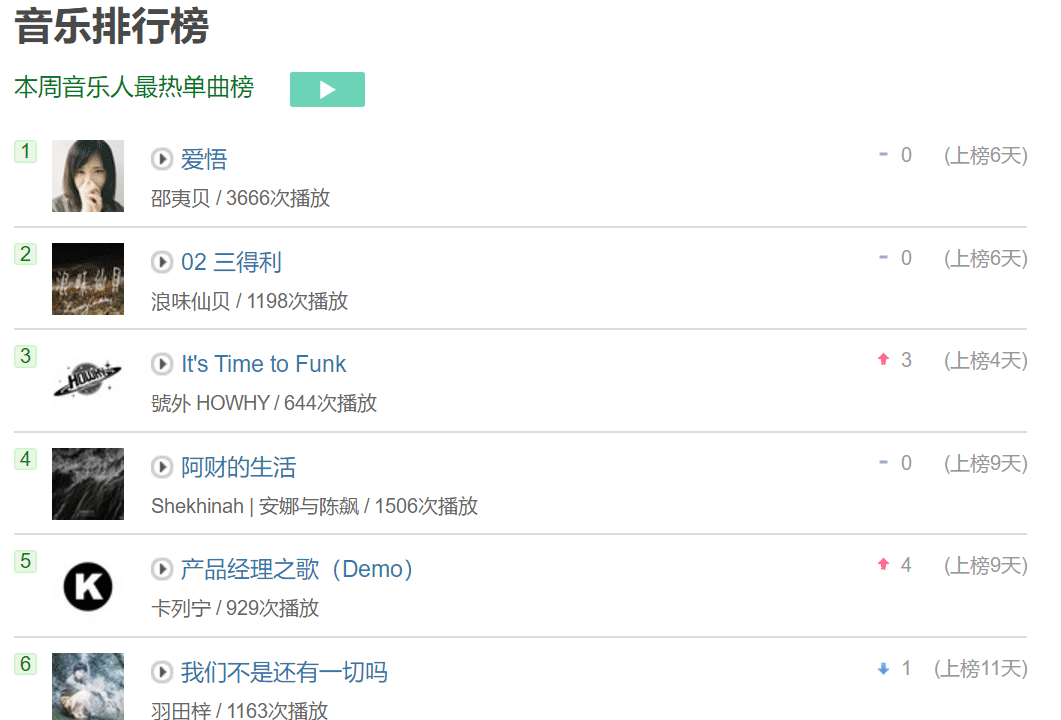
下面分析怎么通过beautiful soup抓取到我们的数据。 通过开发者工具,我们可以看到所有歌曲是在class为article的div中,然后每首个在class为clearfix的li中。

因此首先使用css选择器获取到class为article下面的所有li节点:
soup.select(".article li")
然后查看每首歌曲的html代码:

红色框部分是一首歌的html代码。 歌曲排名在class为“gree-num-box”的span节点中,因为span节点是<li class="clearfix">节点的子节点,获取排名的代码为:li.span.text
绿色框中A节点中是歌曲的链接和图片链接,获取歌曲链接的代码为:li.a['href']
蓝色框中是歌曲的名字、演唱者和播放次数,歌曲名是在class=”icon-play”的H3节点中,因此可以使用方法选择器中的find()方法获取到H3节点,然后获取H3节点下面a节点中的文本信息就是歌曲的名字,代码为:li.find(class_="icon-play").a.text
获取演唱者和播放次数的代码为: li.find(class_="intro").p.text.strip()
获取上榜天数的代码为:
li.find(class_="days").text.strip()
在豆瓣音乐排行榜的页面一个现实20首歌曲,前面10首歌曲会有图片,后面10首歌曲是没有图片的,因此后面10首歌曲将不获取图片的地址。
另外还有一点需要注意的是,后面10首歌曲的演唱者和播放次数是在class=”icon-play”的p节点中:

而该节点中有a节点,要想获取a节点外的信息,必须使用节点选择器的contents方法: li.find(class_="intro").p.contents[2].strip() contents返回的是p节点的直接子节点,以列表的形式返回,这里返回列表中有3个元素,分别是<p>后的字符串,a节点、演唱者/播次数。contents会将直接子节点之间的换行符也当做一个元素。 代码整理后如下:
# coding:utf-8

from bs4 import BeautifulSoup
import requests
def parseHtml(url):
  headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0"}

  response = requests.get(url,headers=headers)
  soup = BeautifulSoup(response.text,'lxml')
  #使用css选择器获取class="article"的节点下面的所有li节点
  for index,li in enumerate(soup.select(".article li")):
    if(index <10):
      print('歌曲排名:' + li.span.text)
      print('歌曲链接:' + li.a['href'])
      print('歌曲名:' + li.find(class_="icon-play").a.text)#使用方法选择器
      print('演唱者/播放次数:' + li.find(class_="intro").p.text.strip())
      print('上榜时间:'+li.find(class_="days").text.strip())
    else:
      print('歌曲排名:' + li.span.text)
      print('歌曲名:' + li.find(class_="icon-play").a.text)
      print('演唱者/播放次数:' + li.find(class_="intro").p.contents[2].strip())#方法选择器和节点选择器搭配使用
      print('上榜时间:' + li.find(class_="days").text.strip())
    print('—————————————————强力分隔符———————————————————')

def main():
  url = "https://music.douban.com/chart"
  parseHtml(url)

if __name__ == '__main__':
  main()
本文通过爬取豆瓣音乐排行榜的小项目学习了如何使用Beautiful Soup的节点选择器、方法选择器、CSS选择器来爬取一个网页。这三个选择器可以混合搭配使用。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。