python爬虫 基于requests模块发起ajax的get请求实现解析
基于requests模块发起ajax的get请求
需求:爬取豆瓣电影分类排行榜 https://movie.douban.com/中的电影详情数据
用抓包工具捉取 使用ajax加载页面的请求
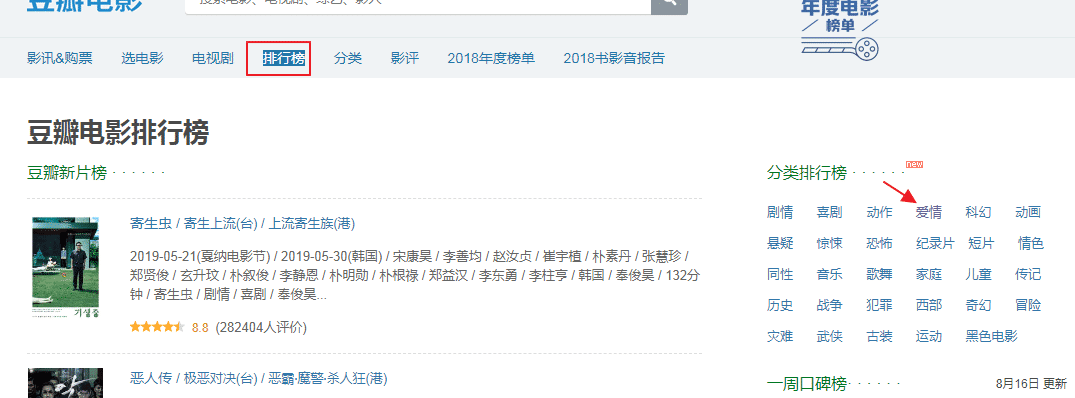
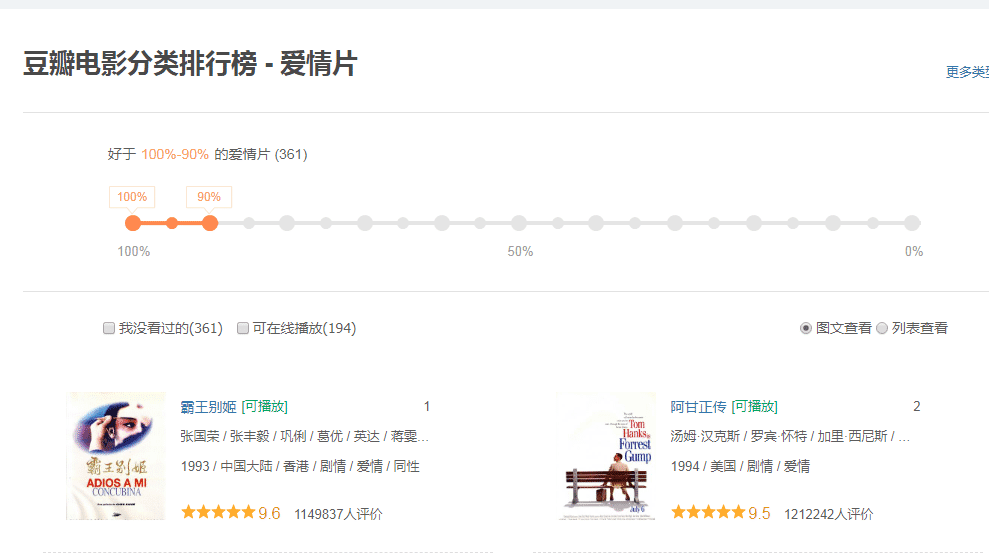
鼠标往下下滚轮拖动页面,会加载更多的电影信息,这个局部刷新是当前页面发起的ajax请求,
用抓包工具捉取页面刷新的ajax的get请求,捉取滚轮在最底部时候发起的请求
这个get请求是本次发起的请求的url

ajax的get请求携带参数

获取响应内容不再是页面数据,是json字符串,是通过异步请求获取的电影详情信息
start和limit参数 需要注意,改变这两个参数获取的电影详情不一样
import requests
import json
# 指定ajax-get请求的url(通过抓包进行获取)
url = 'https://movie.douban.com/j/chart/top_list?'
# 封装ajax的get请求携带的参数(从抓包工具中获取) 封装到字典
param = {
  'type': '13',
  'interval_id': '100:90',
  'action': '',
  'start': '20', # 从第20个电影开始获取详情
  'limit': '20', # 获取多少个电影详情
  # 改变这两个参数获取的电影详情不一样
}
# 定制请求头信息,相关的头信息必须封装在字典结构中
headers = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36',
}
# 发起ajax的get请求还是用get方法
response = requests.get(url=url,params=param,headers=headers)

# 获取响应内容:响应内容为json字符串
data = response.text
data = json.loads(data)
for data_dict in data:
  print(data_dict["rank"],data_dict["title"])

'''
芙蓉镇
沉静如海
淘金记
马戏团
情迷意乱
士兵之歌
战争与和平
怦然心动
大话西游之月光宝盒
罗马假日
音乐之声
一一
雨中曲
我爱你
莫娣
卡比利亚之夜
婚姻生活
本杰明·巴顿奇事
情书
春光乍泄
'''
从21个电影开始获取信息,总共获取20个电影详情信息
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。