python 实现文件的递归拷贝实现代码
所以就想把这些照片翻着看一遍,可是拷出来的照片手机
里是按时间自动分文件夹的,一个一个文件夹拷很是麻烦,于是打算写个python小脚本来完成这个工作(扯这么多,终于
到主题了,囧)
废话少说,上代码:
# -*- coding: utf-8 -*-
#!/usr/bin/python
#Filename:copyfile.py
import os,shutil
def mycopy(srcpath,dstpath):
if not os.path.exists(srcpath):
print "srcpath not exist!"
if not os.path.exists(dstpath):
print "dstpath not exist!"
for root,dirs,files in os.walk(srcpath,True):
for eachfile in files:
shutil.copy(os.path.join(root,eachfile),dstpath)
srcpath='e:\\pic'
dstpath='f:\\pictotal'
mycopy(srcpath,dstpath)
运行这个脚本,去f盘看看:
代码没有什么难懂的,主要是os.walk()函数,这个函数返回指定路径的三元组(起始路径,起始路径下的目录,起始路径下不带路径名的文件名列表)
它直接可以递归遍历到指定目录下的所有目录及文件名,比较好用。
也可以用os.listdir(dirname):函数来实现,listdir函数列出dirname下的目录和文件,然后通过一个判断:若是文件,则拷贝;若是目录,则继续递归
遍历,显然没有walk()函数用起来方便。不过不知道walk()函数内部是怎么实现的,若是直接将根目录下的所有文件存在list中性能上可能不太好,
后面可以用listdir()对比测一下。
可以看出,python仅需短短几行的代码就完成了这个工作,还是很方便的。若用C++来实现代码就比这个长了。
可见,语言无所谓高低,能高效方便实现目标就好,不是吗?
里是按时间自动分文件夹的,一个一个文件夹拷很是麻烦,于是打算写个python小脚本来完成这个工作(扯这么多,终于
到主题了,囧)

废话少说,上代码:
复制代码 代码如下:
# -*- coding: utf-8 -*-
#!/usr/bin/python
#Filename:copyfile.py
import os,shutil
def mycopy(srcpath,dstpath):
if not os.path.exists(srcpath):
print "srcpath not exist!"
if not os.path.exists(dstpath):
print "dstpath not exist!"
for root,dirs,files in os.walk(srcpath,True):
for eachfile in files:
shutil.copy(os.path.join(root,eachfile),dstpath)
srcpath='e:\\pic'
dstpath='f:\\pictotal'
mycopy(srcpath,dstpath)
运行这个脚本,去f盘看看:
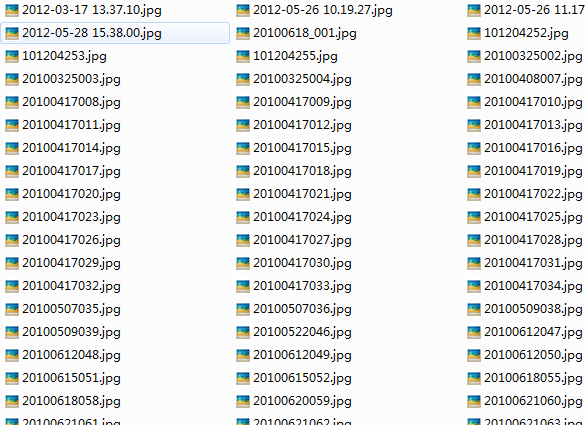
代码没有什么难懂的,主要是os.walk()函数,这个函数返回指定路径的三元组(起始路径,起始路径下的目录,起始路径下不带路径名的文件名列表)
它直接可以递归遍历到指定目录下的所有目录及文件名,比较好用。
也可以用os.listdir(dirname):函数来实现,listdir函数列出dirname下的目录和文件,然后通过一个判断:若是文件,则拷贝;若是目录,则继续递归
遍历,显然没有walk()函数用起来方便。不过不知道walk()函数内部是怎么实现的,若是直接将根目录下的所有文件存在list中性能上可能不太好,
后面可以用listdir()对比测一下。
可以看出,python仅需短短几行的代码就完成了这个工作,还是很方便的。若用C++来实现代码就比这个长了。
可见,语言无所谓高低,能高效方便实现目标就好,不是吗?