python抓取京东价格分析京东商品价格走势

yipeiwu_com7年前Python爬虫

复制代码 代码如下:

from creepy import Crawler
from BeautifulSoup import BeautifulSoup
import urllib2
import json

class MyCrawler(Crawler):
    def process_document(self, doc):
        if doc.status == 200:
            print '[%d] %s' % (doc.status, doc.url)
            try:
                soup = BeautifulSoup(doc.text.decode('gb18030').encode('utf-8'))
            except Exception as e:
                print e
                soup = BeautifulSoup(doc.text)
            print soup.find(id="product-intro").div.h1.text
            url_id=urllib2.unquote(doc.url).decode('utf8').split('/')[-1].split('.')[0]
            f = urllib2.urlopen('http://p.3.cn/prices/get?skuid=J_'+url_id,timeout=5)
            price=json.loads(f.read())
            f.close()
            print price[0]['p']
        else:
            pass

crawler = MyCrawler()
crawler.set_follow_mode(Crawler.F_SAME_HOST)
crawler.set_concurrency_level(16)
crawler.add_url_filter('\.(jpg|jpeg|gif|png|js|css|swf)$')
crawler.crawl('http://item.jd.com/982040.html')
相关文章

python爬虫之线程池和进程池功能与用法详解

python爬虫之线程池和进程池功能与用法详解

本文实例讲述了python爬虫之线程池和进程池功能与用法。分享给大家供大家参考,具体如下: 一、需求 最近准备爬取某电商网站的数据,先不考虑代理、分布式,先说效率问题(当然你要是请求的太...

通过selenium抓取某东的TT购买记录并分析趋势过程解析

通过selenium抓取某东的TT购买记录并分析趋势过程解析

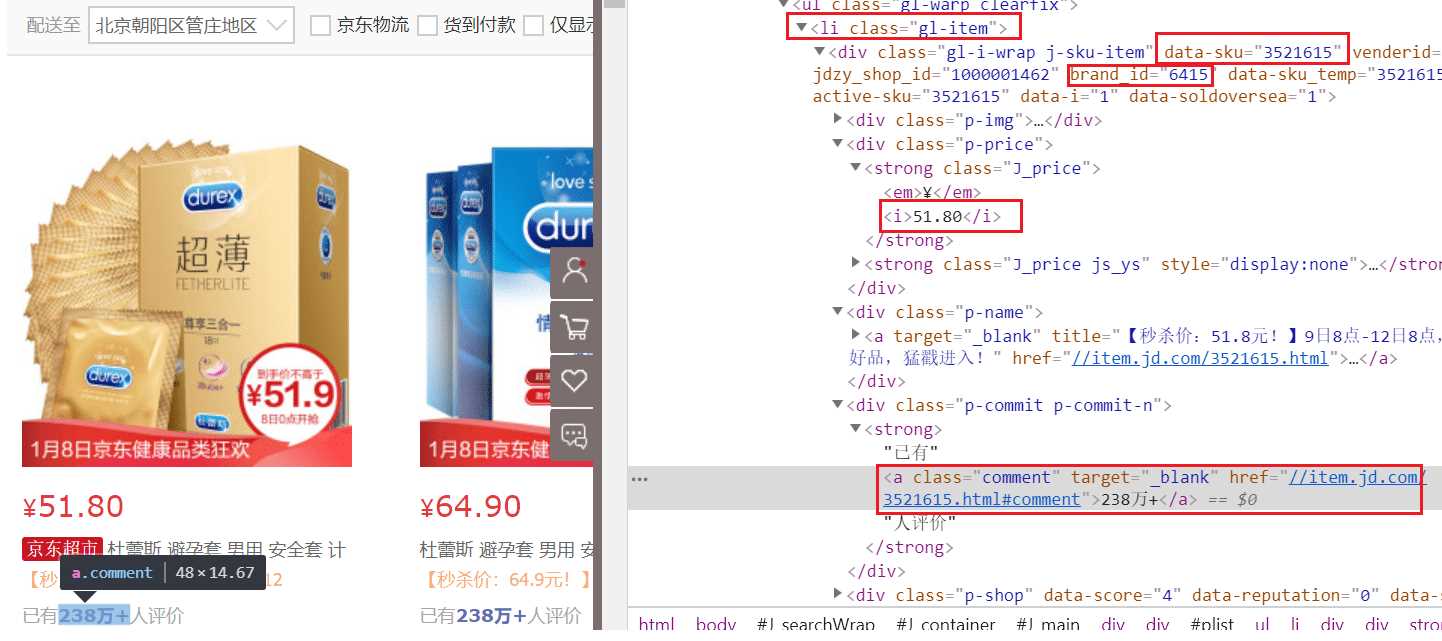
最近学习了一些爬虫技术,想做个小项目检验下自己的学习成果,在逛某东的时候,突然给我推荐一个TT的产品,点击进去浏览一番之后就产生了抓取TT产品,然后进行数据分析,看下那个品牌的TT卖得最...

Python之多线程爬虫抓取网页图片的示例代码

Python之多线程爬虫抓取网页图片的示例代码

目标 嗯,我们知道搜索或浏览网站时会有很多精美、漂亮的图片。 我们下载的时候,得鼠标一个个下载,而且还翻页。 那么,有没有一种方法,可以使用非人工方式自动识别并下载图片。美美哒。 那么请...

Python实现多线程抓取网页功能实例详解

本文实例讲述了Python实现多线程抓取网页功能。分享给大家供大家参考,具体如下: 最近,一直在做网络爬虫相关的东西。 看了一下开源C++写的larbin爬虫,仔细阅读了里面的设计思想和...

Python爬虫获取图片并下载保存至本地的实例

1、抓取煎蛋网上的图片。 2、代码如下: import urllib.request import os #to open the url def url_open(url): r...