python爬虫教程之爬取百度贴吧并下载的示例

yipeiwu_com7年前Python爬虫

测试url:http://tieba.baidu.com/p/27141123322?pn=
begin  1
end   4

复制代码 代码如下:

import string ,urllib2

def baidu_tieba(url,begin_page,end_page):
    for i in range(begin_page, end_page+1):
        sName = string.zfill(i,5)+ '.html'
        print '正在下载第' + str(i) + '个网页,并将其存储为' + sName + '..........'
        f = open (sName,'w+')
        m = urllib2.urlopen(url + str(i)).read()
        f.write(m)
        f.close()


bdurl = str(raw_input('url:  \n'))
begin_page = int(raw_input('begin :\n'))
end_page = int(raw_input('end : \n'))

baidu_tieba(bdurl,begin_page,end_page)
相关文章

selenium+PhantomJS爬取豆瓣读书

本文实例为大家分享了selenium+PhantomJS爬取豆瓣读书的具体代码,供大家参考,具体内容如下 获取关于Python的全部书籍信息; 通过代码测试 request携带‘User...

python定向爬取淘宝商品价格

python爬虫学习之定向爬取淘宝商品价格,供大家参考,具体内容如下 import requests import re def getHTMLText(url): try:...

python使用webdriver爬取微信公众号

本文实例为大家分享了python使用webdriver爬取微信公众号的具体代码,供大家参考,具体内容如下 # -*- coding: utf-8 -*- from seleniu...

Python抓取框架Scrapy爬虫入门:页面提取

前言 Scrapy是一个非常好的抓取框架,它不仅提供了一些开箱可用的基础组建,还能够根据自己的需求,进行强大的自定义。本文主要给大家介绍了关于Python抓取框架Scrapy之页面提取的...

Python网络爬虫中的同步与异步示例详解

Python网络爬虫中的同步与异步示例详解

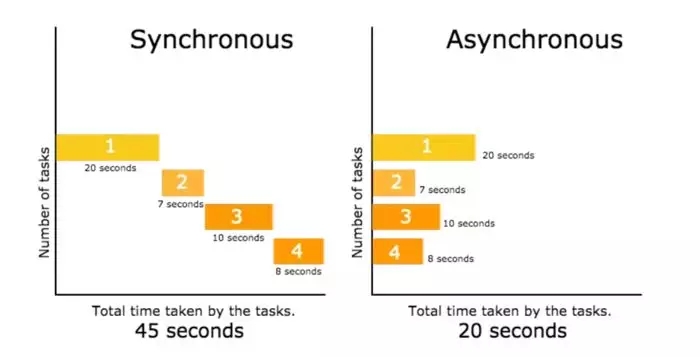
一、同步与异步 #同步编程(同一时间只能做一件事,做完了才能做下一件事情) <-a_url-><-b_url-><-c_url-> #异步编程...