Python3访问并下载网页内容的方法

yipeiwu_com7年前Python基础

本文实例讲述了Python3访问并下载网页内容的方法。分享给大家供大家参考。具体如下:

#!/usr/local/bin/python3.2
import urllib.request,io,os,sys
req = urllib.request.Request("http://www.google.com")
f = urllib.request.urlopen(req)
s = f.read()
s = s.decode('gbk','ignore')
mdir = sys.path[0]+'/'
file = open(mdir+'admin6.txt','a',1,'gbk')
file.write(s)
file.close()

希望本文所述对大家的Python程序设计有所帮助。
相关文章

Python中的__slots__示例详解

前言 相信Python老鸟都应该看过那篇非常有吸引力的Saving 9 GB of RAM with Python's slots 文章,作者使用了__slots__让内存占用从25.5...

Python使用PIL模块生成随机验证码

Python生成随机验证码,需要使用PIL模块,具体内容如下 安装: pip3 install pillow 基本使用 1. 创建图片 from PIL import Ima...

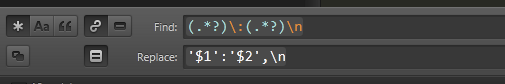
正则给header的冒号两边参数添加单引号(Python请求用)

正则给header的冒号两边参数添加单引号(Python请求用)

正则给header的冒号两边参数添加单引号(Python请求用) 直接从浏览器Chrome复制header值如下: Host: kyfw.12306.cn Connection:...

python 含子图的gif生成时内存溢出的方法

今天想用python做个demo,含两个子图的动态gif,代码如下: import matplotlib.pyplot as plt import imageio,os import...

Python中用于计算对数的log()方法

 log()方法返回x的自然对数,对于x>0。 语法 以下是log()方法的语法: import math math.log( x ) 注意:此函数是无法直接...