python数据清洗系列之字符串处理详解
前言
数据清洗是一项复杂且繁琐(kubi)的工作,同时也是整个数据分析过程中最为重要的环节。有人说一个分析项目80%的时间都是在清洗数据,这听起来有些匪夷所思,但在实际的工作中确实如此。数据清洗的目的有两个,第一是通过清洗让数据可用。第二是让数据变的更适合进行后续的分析工作。换句话说就是有”脏”数据要洗,干净的数据也要洗。
在数据分析中,特别是文本分析中,字符处理需要耗费极大的精力,因而了解字符处理对于数据分析而言,也是一项很重要的能力。
字符串处理方法
首先我们先了解下都有哪些基础方法
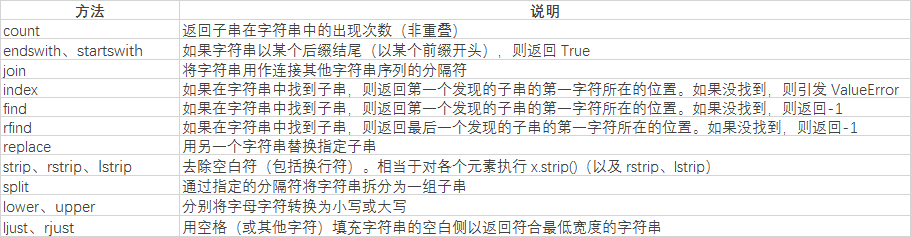
首先我们了解下字符串的拆分split方法
str='i like apple,i like bananer'
print(str.split(','))
对字符str用逗号进行拆分的结果:
['i like apple', 'i like bananer']
print(str.split(' '))
根据空格拆分的结果:
['i', 'like', 'apple,i', 'like', 'bananer']
print(str.index(','))
print(str.find(','))
两个查找结果都为:
12
找不到的情况下index返回错误,find返回-1
print(str.count('i'))
结果为:
4
connt用于统计目标字符串的频率
print(str.replace(',', ' ').split(' '))
结果为:
['i', 'like', 'apple', 'i', 'like', 'bananer']
这里replace把逗号替换为空格后,在用空格对字符串进行分割,刚好能把每个单词取出来。
除了常规的方法以外,更强大的字符处理工具费正则表达式莫属了。
正则表达式
在使用正则表达式前我们还要先了解下,正则表达式中的诸多方法。

下面我来看下个方法的使用,首先了解下match和search方法的区别
str = "Cats are smarter than dogs"
pattern=re.compile(r'(.*) are (.*?) .*')
result=re.match(pattern,str)

for i in range(len(result.groups())+1):
 print(result.group(i))
结果为:
Cats are smarter than dogs
Cats
smarter
这种形式的pettern匹配规则下,match和search方法的的返回结果是一样的
此时如果把pattern改为
pattern=re.compile(r'are (.*?) .*')
match则返回none,search返回结果为:
are smarter than dogs
smarter
接下来我们了解下其他方法的使用
str = "138-9592-5592 # number"
pattern=re.compile(r'#.*$')
number=re.sub(pattern,'',str)
print(number)
结果为:
138-9592-5592
以上是通过把#号后面的内容替换为空实现提取号码的目的。
我们还可以进一步对号码的横杆进行替换
print(re.sub(r'-*','',number))
结果为:
13895925592
我们还可以用find的方法把找到的字符串打印出来
str = "138-9592-5592 # number"
pattern=re.compile(r'5')
print(pattern.findall(str))
结果为:
['5', '5', '5']
正则表达式的整体内容比较多,需要我们对匹配的字符串的规则有足够的了解,下面是具体的匹配规则。

矢量化字符串函数
清理待分析的散乱数据时,常常需要做一些字符串规整化工作。
data = pd.Series({'li': '120@qq.com','wang':'5632@qq.com',
 'chen': '8622@xinlang.com','zhao':np.nan,'sun':'5243@gmail.com'})
print(data)
结果为:

可以通过规整合的一些方法对数据做初步的判断,比如用contains 判断每个数据中是否含有关键词
print(data.str.contains('@'))
结果为:

也可以对字符串进行分拆,把需要的字符串提取出来
data = pd.Series({'li': '120@qq.com','wang':'5632@qq.com',
     'chen': '8622@xinlang.com','zhao':np.nan,'sun':'5243@gmail.com'})
pattern=re.compile(r'(\d*)@([a-z]+)\.([a-z]{2,4})')
result=data.str.match(pattern) #这里用fillall的方法也可以result=data.str.findall(pattern)
print(result)
结果为:
chen [(8622, xinlang, com)]
li [(120, qq, com)]
sun [(5243, gmail, com)]
wang [(5632, qq, com)]
zhao NaN
dtype: object
此时加入我们需要提取邮箱前面的名称
print(result.str.get(0))
结果为:

或者需要邮箱所属的域名
print(result.str.get(1))
结果为:

当然也可以用切片的方式进行提取,不过提取的数据准确性不高
data = pd.Series({'li': '120@qq.com','wang':'5632@qq.com',
    'chen': '8622@xinlang.com','zhao':np.nan,'sun':'5243@gmail.com'})
print(data.str[:6])
结果为:

最后我们了解下矢量化的字符串方法

总结
以上就是python数据清洗之字符串处理的全部内容了,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流。