python爬虫实战之最简单的网页爬虫教程
前言
网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。最近对python爬虫有了强烈地兴趣,在此分享自己的学习路径,欢迎大家提出建议。我们相互交流,共同进步。话不多说了,来一起看看详细的介绍:
1.开发工具
笔者使用的工具是sublime text3,它的短小精悍(可能男人们都不喜欢这个词)使我十分着迷。推荐大家使用,当然如果你的电脑配置不错,pycharm可能更加适合你。
sublime text3搭建python开发环境推荐查看这篇文章:
[sublime搭建python开发环境][/post/51838.htm]
2.爬虫介绍
爬虫顾名思义,就是像虫子一样,爬在Internet这张大网上。如此,我们便可以获取自己想要的东西。
既然要爬在Internet上,那么我们就需要了解URL,法号“统一资源定位器”,小名“链接”。其结构主要由三部分组成:
(1)协议:如我们在网址中常见的HTTP协议。
(2)域名或者IP地址:域名,如:www.baidu.com,IP地址,即将域名解析后对应的IP。
(3)路径:即目录或者文件等。
3.urllib开发最简单的爬虫
(1)urllib简介
| Module | Introduce |
|---|---|
| urllib.error | Exception classes raised by urllib.request. |
| urllib.parse | Parse URLs into or assemble them from components. |
| urllib.request | Extensible library for opening URLs. |
| urllib.response | Response classes used by urllib. |
| urllib.robotparser | Load a robots.txt file and answer questions about fetchability of other URLs. |
(2)开发最简单的爬虫
百度首页简洁大方,很适合我们爬虫。
爬虫代码如下:
from urllib import request

def visit_baidu():
 URL = "http://www.baidu.com"
 # open the URL
 req = request.urlopen(URL)
 # read the URL
 html = req.read()
 # decode the URL to utf-8
 html = html.decode("utf_8")
 print(html)

if __name__ == '__main__':
 visit_baidu()
结果如下图:
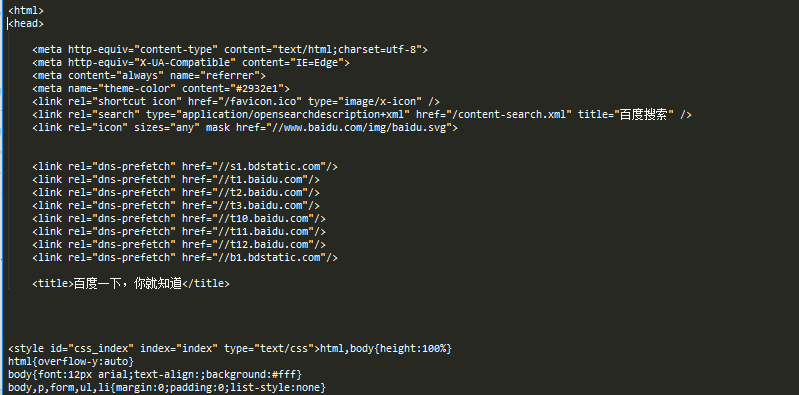
我们可以通过在百度首页空白处右击,查看审查元素来和我们的运行结果对比。
当然,request也可以生成一个request对象,这个对象可以用urlopen方法打开。
代码如下:
from urllib import request

def vists_baidu():
 # create a request obkect
 req = request.Request('http://www.baidu.com')
 # open the request object
 response = request.urlopen(req)
 # read the response
 html = response.read()
 html = html.decode('utf-8')
 print(html)

if __name__ == '__main__':
 vists_baidu()
运行结果和刚才相同。
(3)错误处理
错误处理通过urllib模块来处理,主要有URLError和HTTPError错误,其中HTTPError错误是URLError错误的子类,即HTTRPError也可以通过URLError捕获。
HTTPError可以通过其code属性来捕获。
处理HTTPError的代码如下:
from urllib import request
from urllib import error

def Err():
 url = "https://segmentfault.com/zzz"
 req = request.Request(url)

 try:
 response = request.urlopen(req)
 html = response.read().decode("utf-8")
 print(html)
 except error.HTTPError as e:
 print(e.code)
if __name__ == '__main__':
 Err()
运行结果如图:
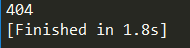
404为打印出的错误代码,关于此详细信息大家可以自行百度。
URLError可以通过其reason属性来捕获。
chuliHTTPError的代码如下:
from urllib import request
from urllib import error

def Err():
 url = "https://segmentf.com/"
 req = request.Request(url)

 try:
 response = request.urlopen(req)
 html = response.read().decode("utf-8")
 print(html)
 except error.URLError as e:
 print(e.reason)
if __name__ == '__main__':
 Err()
运行结果如图:
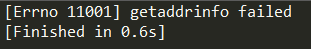
既然为了处理错误,那么最好两个错误都写入代码中,毕竟越细致越清晰。须注意的是,HTTPError是URLError的子类,所以一定要将HTTPError放在URLError的前面,否则都会输出URLError的,如将404输出为Not Found。
代码如下:
from urllib import request
from urllib import error

# 第一种方法,URLErroe和HTTPError
def Err():
 url = "https://segmentfault.com/zzz"
 req = request.Request(url)

 try:
 response = request.urlopen(req)
 html = response.read().decode("utf-8")
 print(html)
 except error.HTTPError as e:
 print(e.code)
 except error.URLError as e:
 print(e.reason)
大家可以更改url来查看各种错误的输出形式。
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对【听图阁-专注于Python设计】的支持。