python 实现一个贴吧图片爬虫的示例
今天没事回家写了个贴吧图片下载程序,工具用的是PyCharm,这个工具很实用,开始用的Eclipse,但是再使用类库或者其它方便并不实用,所以最后下了个专业开发python程序的工具,开发环境是Python2,因为大学时自学的是python2
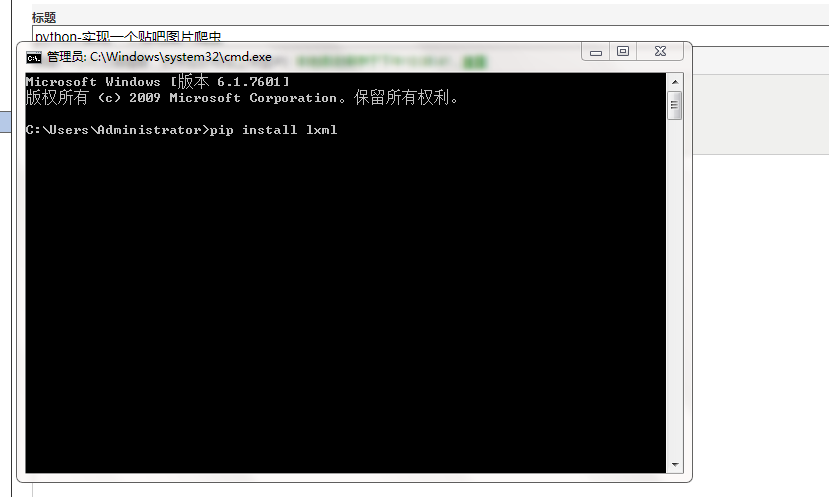
第一步:就是打开cmd命令,输入pip install lxml
如图
第二步:下载一个chrome插件:专门用来将html文件转为xml用xpth技术定位
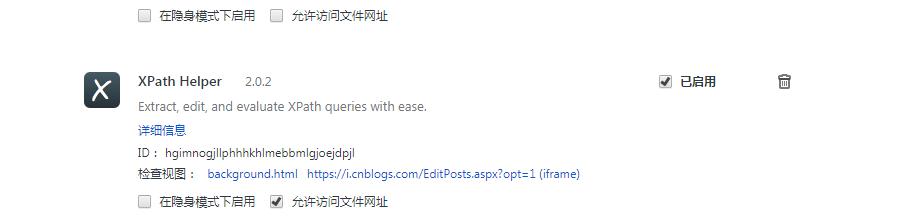
在页面按下Ctrl+Shift+X即可打开插件进行页面分析
如下图
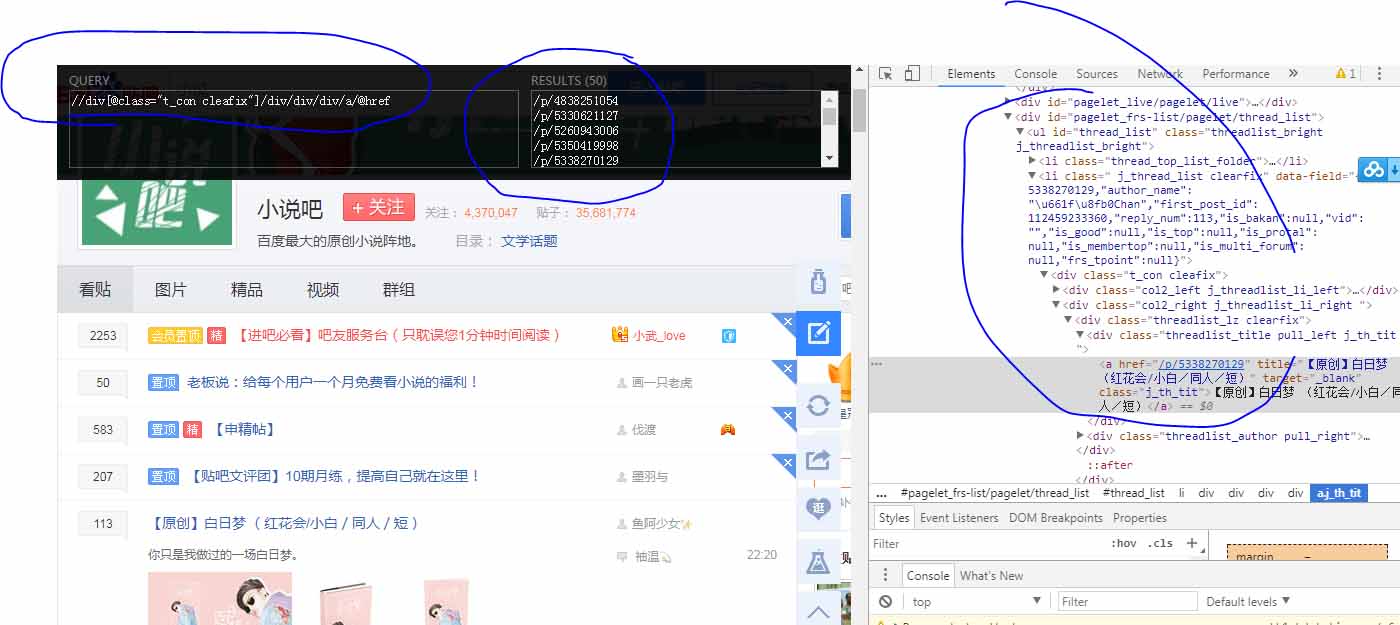
图中的黑色方框左边填写xpth,右边会返回对应的结果,可以看到当前页面的帖子全部抓取到了。xpth具体怎么写要根据右边的检查元素来具体分析,寻找规律,每个网站的方式不一样,但是细心寻找可以找到相同的规律。
找到规律并能匹配上开始写代码了:go
至于代码我对于每行尽量标上注释,方便大家理解
# -*- coding:utf-8 -*-

import urllib
import urllib2
from lxml import etree


def loadPage(url):
 """
  作用:根据url发送请求,获取服务器响应文件
  url: 需要爬取的url地址
 """
 #print url
 #美女
 # headers = {"User-Agent" : "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_7_0) AppleWebKit/535.11 (KHTML, like Gecko) Chrome/17.0.963.56 Safari/535.11"}

 request = urllib2.Request(url)
 html = urllib2.urlopen(request).read()
 # 解析HTML文档为HTML DOM模型
 content = etree.HTML(html)
 #print content
 # 返回所有匹配成功的列表集合
 link_list = content.xpath('//div[@class="t_con cleafix"]/div/div/div/a/@href')

 #link_list = content.xpath('//a[@class="j_th_tit"]/@href')
 for link in link_list:
  fulllink = "http://tieba.baidu.com" + link
  # 组合为每个帖子的链接
  #print link
  loadImage(fulllink)


# 取出每个帖子里的每个图片连接
def loadImage(link):
 headers = {"User-Agent" : "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}
 request = urllib2.Request(link, headers = headers)
 html = urllib2.urlopen(request).read()
 # 解析
 content = etree.HTML(html)
 # 取出帖子里每层层主发送的图片连接集合
 #link_list = content.xpath('//img[@class="BDE_Image"]/@src')
 #link_list = content.xpath('//div[@class="post_bubble_middle"]')
 link_list = content.xpath('//img[@class="BDE_Image"]/@src')
 # 取出每个图片的连接
 for link in link_list:
  print link
  writeImage(link)


def writeImage(link):
 """
  作用:将html内容写入到本地
  link:图片连接
 """
 #print "正在保存 " + filename
 headers = {"User-Agent" : "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}
 # 文件写入
 request = urllib2.Request(link, headers = headers)
 # 图片原始数据
 image = urllib2.urlopen(request).read()
 # 取出连接后10位做为文件名
 filename = link[-10:]
 # 写入到本地磁盘文件内
 with open("d:\image\\"+filename, "wb") as f:
  f.write(image)
 print "已经成功下载 "+ filename

def tiebaSpider(url, beginPage, endPage):
 """
  作用:贴吧爬虫调度器,负责组合处理每个页面的url
  url : 贴吧url的前部分
  beginPage : 起始页
  endPage : 结束页
 """
 for page in range(beginPage, endPage + 1):
  pn = (page - 1) * 50
  filename = "第" + str(page) + "页.html"
  fullurl = url + "&pn=" + str(pn)
  print fullurl
  loadPage(fullurl)
  #print html

  print "谢谢使用"

if __name__ == "__main__":
 kw = raw_input("请输入需要爬取的贴吧名:")
 beginPage = int(raw_input("请输入起始页:"))
 endPage = int(raw_input("请输入结束页:"))

 url = "http://tieba.baidu.com/f?"
 key = urllib.urlencode({"kw": kw})
 fullurl = url + key
 tiebaSpider(fullurl, beginPage, endPage)
运行:
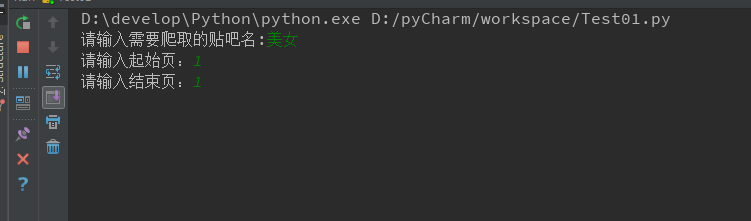

可以看到程序成功运行了,当然我自己的过程并不是一帆风顺,代码仅供参考
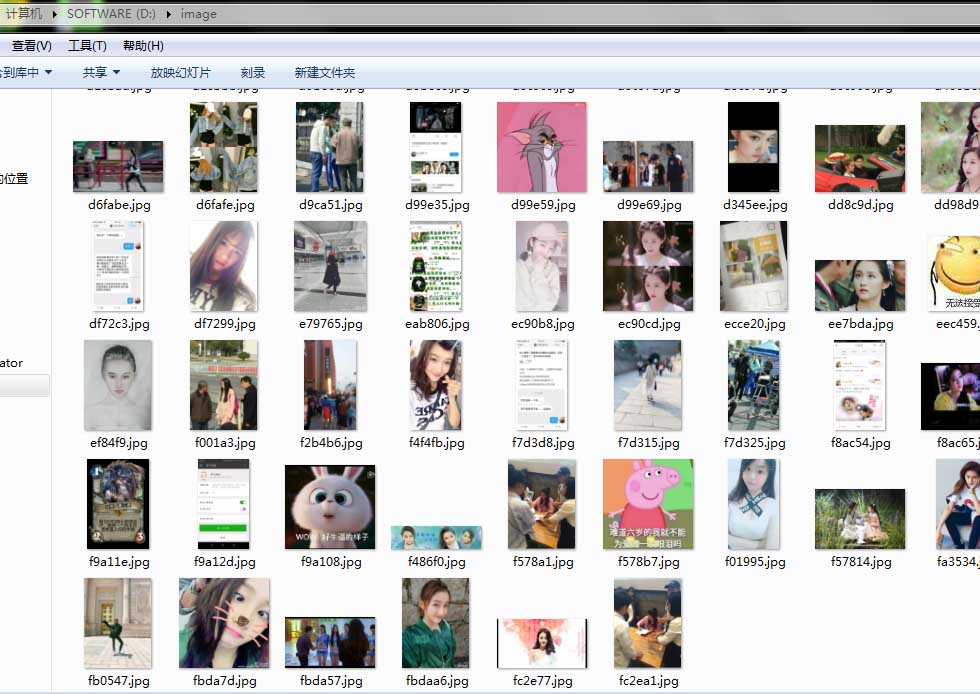
以上这篇python 实现一个贴吧图片爬虫的示例就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。