Python爬虫获取整个站点中的所有外部链接代码示例
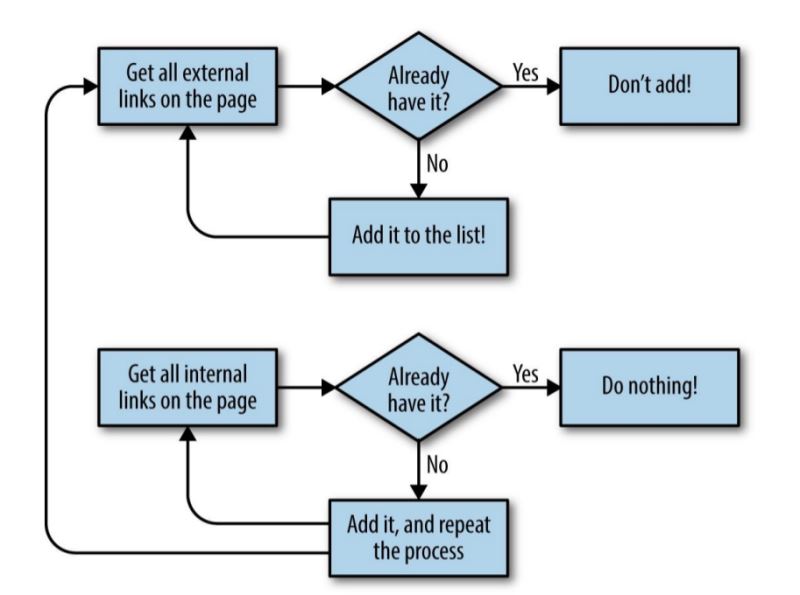
收集所有外部链接的网站爬虫程序流程图
下例是爬取本站python绘制条形图方法代码详解的实例,大家可以参考下。
完整代码:
#! /usr/bin/env python
#coding=utf-8

import urllib2
from  bs4 import BeautifulSoup
import re
import datetime
import random

pages=set()
random.seed(datetime.datetime.now())
#Retrieves a list of all Internal links found on a page
def getInternalLinks(bsObj, includeUrl):
        internalLinks  =  []
        #Finds all links  that  begin  with  a  "/"
        for link  in bsObj.findAll("a", href=re.compile("^(/|.*"+includeUrl+")")):
                if link.attrs['href'] is not None:
                        if link.attrs['href'] not in internalLinks:
                                internalLinks.append(link.attrs['href'])
        return internalLinks
#Retrieves a list of all external links found on a page
def getExternalLinks(bsObj, excludeUrl):
        externalLinks  =  []
        #Finds all links  that  start  with  "http" or "www"  that  do
        #not  contain the current URL
        for link  in bsObj.findAll("a",
                              href=re.compile("^(http|www)((?!"+excludeUrl+").)*$")):
                if link.attrs['href'] is not None:
                        if link.attrs['href'] not in externalLinks:
                                externalLinks.append(link.attrs['href'])
        return externalLinks

def splitAddress(address):
        addressParts  =  address.replace("http://", "").split("/")
        return addressParts

def getRandomExternalLink(startingPage):
        html=  urllib2.urlopen(startingPage)
        bsObj  =  BeautifulSoup(html)
        externalLinks  =  getExternalLinks(bsObj, splitAddress(startingPage)[0])
        if len(externalLinks) == 0:
                internalLinks  =  getInternalLinks(startingPage)
                return internalLinks[random.randint(0, len(internalLinks)-1)]
        else:
                return externalLinks[random.randint(0, len(externalLinks)-1)]

def followExternalOnly(startingSite):
        externalLink=getRandomExternalLink("/post/130968.htm")
        print("Random  external  link  is: "+externalLink)
        followExternalOnly(externalLink)

#Collects a list of all external URLs found on the site
allExtLinks=set()
allIntLinks=set()
def getAllExternalLinks(siteUrl):
    html=urllib2.urlopen(siteUrl)
    bsObj=BeautifulSoup(html)
    internalLinks  =  getInternalLinks(bsObj,splitAddress(siteUrl)[0])
    externalLinks  =  getExternalLinks(bsObj,splitAddress(siteUrl)[0])
    for link in externalLinks:
      if link not in allExtLinks:
        allExtLinks.add(link)
        print(link)
    for link in internalLinks:
      if link not in allIntLinks:
        print("About to get link:"+link)
        allIntLinks.add(link)
        getAllExternalLinks(link)

getAllExternalLinks("/post/130968.htm")
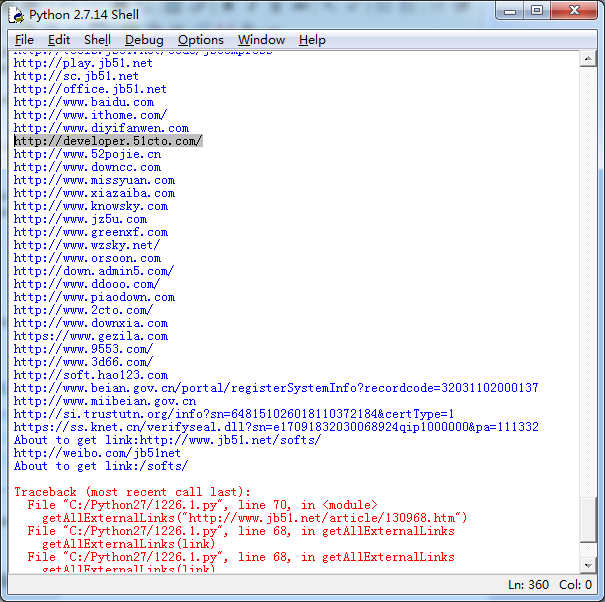
爬取结果如下:
总结
以上就是本文关于Python爬虫获取整个站点中的所有外部链接代码示例的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站其他相关专题,如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!