python实现K最近邻算法
KNN核心算法函数,具体内容如下
#! /usr/bin/env python3
# -*- coding: utf-8 -*-
# fileName : KNNdistance.py
# author : zoujiameng@aliyun.com.cn

import math

def getMaxLocate(target): # 查找target中最大值的locate
 maxValue = float("-inFinIty")
 for i in range(len(target)):
  if maxValue < target[i]:
   maxValue = target[i]
   flag = i
 return flag

def KDistance(K, dest, source):
 destlen = len(dest)
 source1len = len(source[1])
 sourcelen = len(source)
 KNN = []
 locate = source # 准备从source中剔除N-K个最大值

 if destlen == source1len:
  for i in range(sourcelen):
   delta = 0
   for j in range(source1len):# 毕达哥拉斯公式
    delta += (dest[j] - source[i][j])*(dest[j] - source[i][j])
   KNN.append(math.sqrt(delta))

  for k in range(sourcelen, K, -1):
   flag = getMaxLocate(KNN)
   #print("%s 最大元素位置为%d" % (KNN, flag))
   KNN.remove(KNN[flag]);
   locate.remove(locate[flag])# 移除对应位置的元素
   #print(locate)
  return locate # 返回最终K个最接近的元素
 else:
  return None
假设你在伯克利开个小小的面包店,每天都做新鲜面包,需要根据如下一组特征预测当天该烤多少条面包:
a. 天气指数1~5(1表示天气很糟,5表示天气非常好);
b. 是不是周末或节假日(周末或节假日为1,否则为0);
c. 有没有活动(1表示有,0表示没有)。
已知
historyA(5, 1, 0) = 300
historyB(3, 1, 1) = 225
historyC(1, 1, 0) = 75
historyD(4, 0, 1) = 200
historyE(4, 0, 0) = 150
historyF(2, 0, 0) = 50
回归:周末,天气不错
Now(4, 1, 0) = ?
#! /usr/bin/env python3
# -*- coding: utf-8 -*-
# fileName : KNNdistance.py
# author : zoujiameng@aliyun.com.cn

if __name__ == "__main__":

 history = {}
 history[5, 1, 0] = 300
 history[3, 1, 1] = 225
 history[1, 1, 0] = 75
 history[4, 0, 1] = 200
 history[4, 0, 0] = 150
 history[2, 0, 0] = 50

 dest = [4, 1, 0]
 source = []
 for i in history:
  source.append(i)
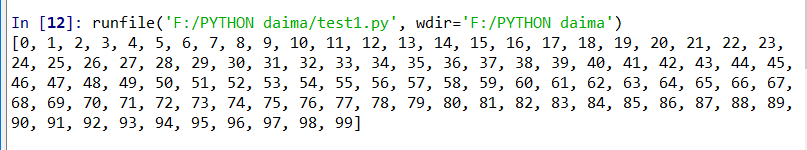
 print(source)

 from KNNdistance import KDistance
 K = 4
 locate = KDistance(K, dest, source)
 avg = 0
 for i in range(len(locate)):
  avg+=history[locate[i]]
 avg/=K
 print("回归结果:今天应该烤%d个面包" % round(avg))
KNN算法:
- 创建分类系统
- 分类(分组),特征抽取(得到相似程度)
- 回归,即预测数值
- KNN算法真的是很有用,堪称你进入神奇的机器学习领域的领路人!机器学习旨在让计算机更聪明。你见过一个机器学习的例子:创建推荐系统。
- OCR指的是光学字符识别 (optical character recognition),这意味着你可拍摄印刷页面的照片,计算机将自动识别出其中的文字。Google使用OCR来实现图书数字化。
- 一般而言,OCR算法提取线段、点和曲线等特征。
- OCR中的特征提取要复杂得多,但再复杂的技术也是基于KNN等简单理念的。这些理念也可用于语音识别和人脸识别。你将照片上传到Facebook时,它有时候能够自动标出照片中的人物,这是机器学习在发挥作用!
- OCR的第一步是查看大量的数字图像并提取特征,这被称为训练(training)。大多数机器学习算法都包含训练的步骤:要让计算机完成任务,必须先训练它。
samples:
a. 垃圾邮件过滤器, 使用一种简单算法——朴素贝叶斯分类器(Naive Bayes classifier)
b. 预测股票市场, 使用机器学习来预测股票市场的涨跌真的很难。对于股票市场,如何挑选合适的特征呢?股票昨天涨了,今天也会涨,这样的特征合适吗?又或者每年五月份股票市场都以绿盘报收,这样的预测可行吗?在根据以往的数据来预测未来方面,没有万无一失的方法。未来很难预测,由于涉及的变量太多,这几乎是不可能完成的任务。
conclude:
机器学习是个很有趣的领域,只要下定决心,你就能很深入地了解它。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。