解决python3爬虫无法显示中文的问题

yipeiwu_com7年前Python爬虫

有时候使用python从网站上爬数据的时候,如果数据里包含中文,有时候显示的却是如下所示...\xe4\xba\xba\xef\xbc\x8c\xe6...类似与国际化

解决方法:

import urllib.request
import sys

weburl="..."
webhead=...
req=urllib.request.Request(url=weburl,headers=webhead)
response=urllib.request.urlopen(req)
content = response.read()
#获得系统的编码
type = sys.getfilesystemencoding()
#设置爬出内容的编码
content = content.decode(type)
file = open("c。txt",'w',10000)
file.write(str(content))
file.close()
print(content)

以上这篇解决python3爬虫无法显示中文的问题就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

零基础写python爬虫之爬虫的定义及URL构成

一、网络爬虫的定义网络爬虫,即Web Spider,是一个很形象的名字。把互联网比喻成一个蜘蛛网,那么Spider就是在网上爬来爬去的蜘蛛。网络蜘蛛是通过网页的链接地址来寻找网页的。从网站...

Python网络爬虫实例讲解

Python网络爬虫实例讲解

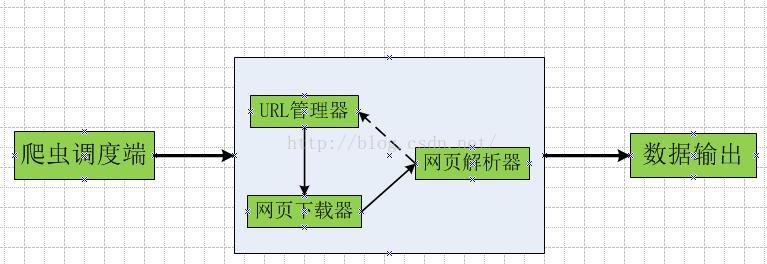
聊一聊Python与网络爬虫。 1、爬虫的定义 爬虫:自动抓取互联网数据的程序。 2、爬虫的主要框架 爬虫程序的主要框架如上图所示,爬虫调度端通过URL管理器获取待爬取的URL链接,若...

Python爬虫使用浏览器cookies:browsercookie过程解析

很多用Python的人可能都写过网络爬虫,自动化获取网络数据确实是一件令人愉悦的事情,而Python很好的帮助我们达到这种愉悦。然而,爬虫经常要碰到各种登录、验证的阻挠,让人灰心丧气(网...

python使用自定义user-agent抓取网页的方法

本文实例讲述了python使用自定义user-agent抓取网页的方法。分享给大家供大家参考。具体如下: 下面python代码通过urllib2抓取指定的url的内容,并且使用自定义的u...

Python实现并行抓取整站40万条房价数据(可更换抓取城市)

Python实现并行抓取整站40万条房价数据(可更换抓取城市)

写在前面 这次的爬虫是关于房价信息的抓取,目的在于练习10万以上的数据处理及整站式抓取。 数据量的提升最直观的感觉便是对函数逻辑要求的提高,针对Python的特性,谨慎的选择数据结构。以...