Python使用爬虫爬取静态网页图片的方法详解
本文实例讲述了Python使用爬虫爬取静态网页图片的方法。分享给大家供大家参考,具体如下:
爬虫理论基础
其实爬虫没有大家想象的那么复杂,有时候也就是几行代码的事儿,千万不要把自己吓倒了。这篇就清晰地讲解一下利用Python爬虫的理论基础。
首先说明爬虫分为三个步骤,也就需要用到三个工具。
① 利用网页下载器将网页的源码等资源下载。
② 利用URL管理器管理下载下来的URL
③ 利用网页解析器解析需要的URL,进而进行匹配。
网页下载器
网页下载器常用的有两个。一个是Python自带的urllib2模块;另一个是第三方控件requests。选用哪个其实差异不大,下一篇将会进行实践操作举例。
URL管理器
url管理器有三大类。
① 内存:以set形式存储在内存中
② 存储在关系型数据库mysql等
③ 缓存数据库redis中
网页解析器
网页解析器一共有四类:
1.正则表达式,不过对于太复杂的匹配就会有些难度,属于模糊匹配。
2.html.parser,这是python自带的解析工具。
3.Beautiful Soup,一种第三方控件,顾名思义,美味的汤,用起来确实很方便,很强大。
4.lxml(apt.xml),第三方控件。
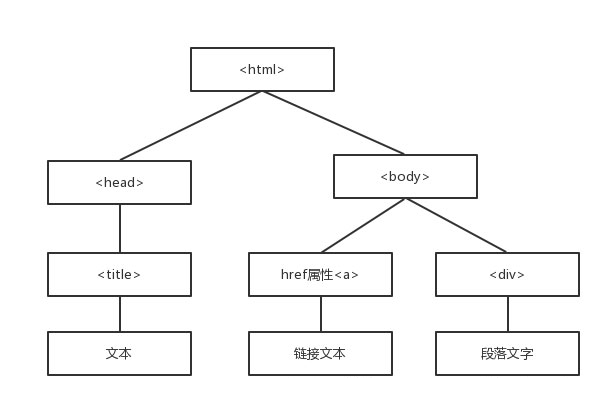
以上的这些全部属于结构化解析(DOM树)
什么式结构化解析(DOM)?
Document Object Model(DOM)是一种树的形式。
Beautiful Soup的语法
html网页—>创建BeautifulSoup对象—>搜索节点 find_all()/find()—>访问节点,名称,属性,文字等……
实现代码
说过了理论基础,那么现在就来实践一个,要爬取一个静态网页的所有图片。
这里使用的网页下载器是python自带的urllib2,然后利用正则表达式匹配,输出结果。
以下为源码:
//引入小需要用到的模块
import urllib2
import re
def main():
  //利用urllib2的urlopen方法,下载当前url的网页内容
  req = urllib2.urlopen('http://www.imooc.com/course/list')
  //将网页内容存储到buf变量中
  buf = req.read()
  //将buf中的所有内容与需要匹配的url进行比对。这里的正则表达式是根据静态网页的源码得出的,查看静态网页源码开启开发者模式,按F12即可。然后确定图片块,查看对应源码内容,找出规律,编写正则表达式。
  listurl = re.findall(r'src=.+\.jpg',buf)
  i = 0
  //将结果循环写入文件
  for url in listurl:
    f = open(str(i)+'.jpg','w')
    req = urllib2.urlopen(url[5:])
    buf1 = req.read()
    f.write(buf1)
    i+=1
if __name__ == '__main__':
  main()
至此一个静态网页的图片爬虫就完成了,下面来看下效果。
这是静态网页:

以下是爬取的结果:

更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。