详解python selenium 爬取网易云音乐歌单名
目标网站:
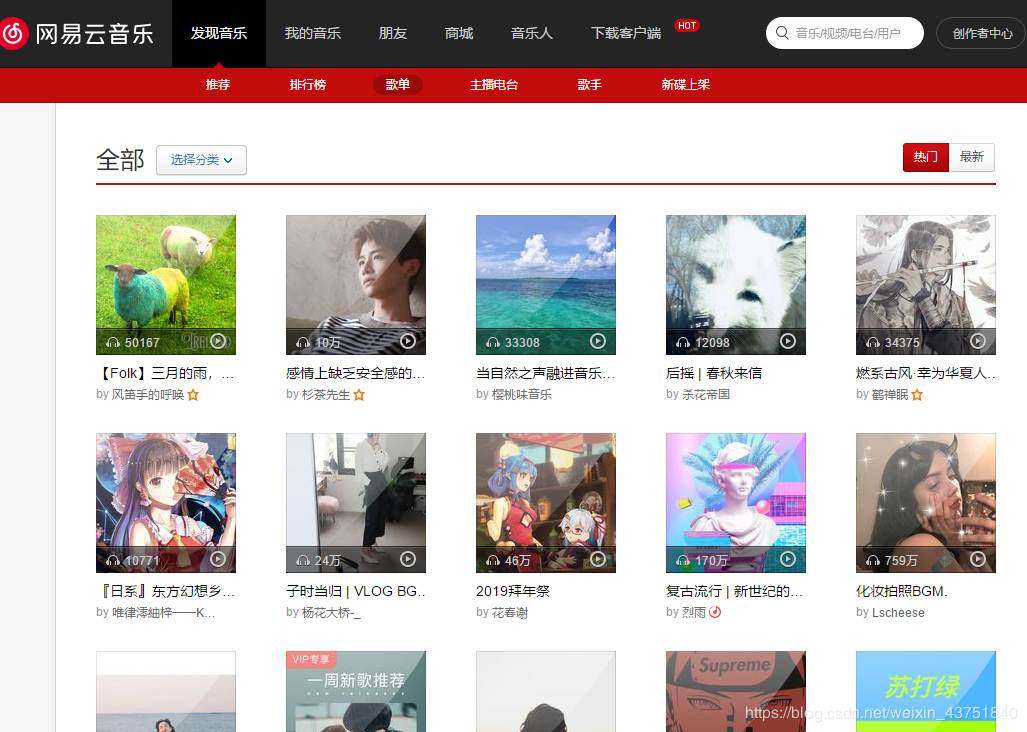
首先获取第一页的数据,这里关键要切换到iframe里
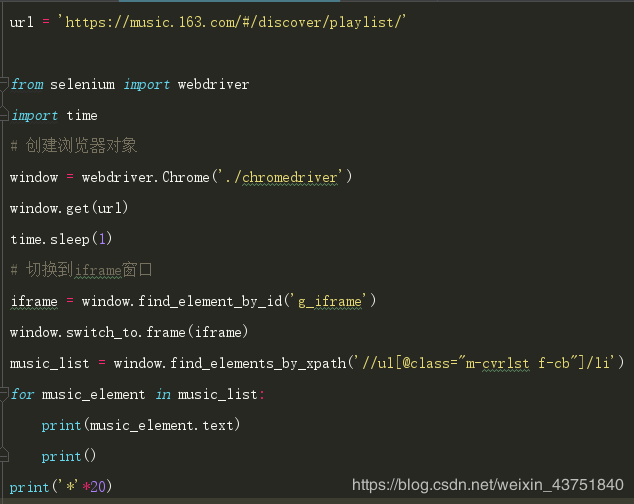
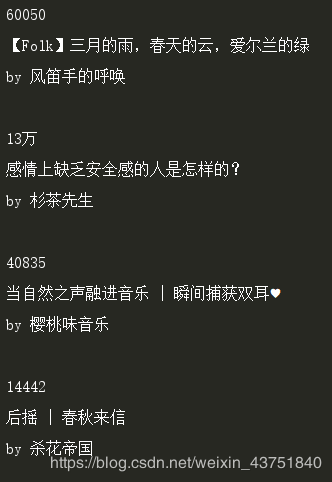
打印一下
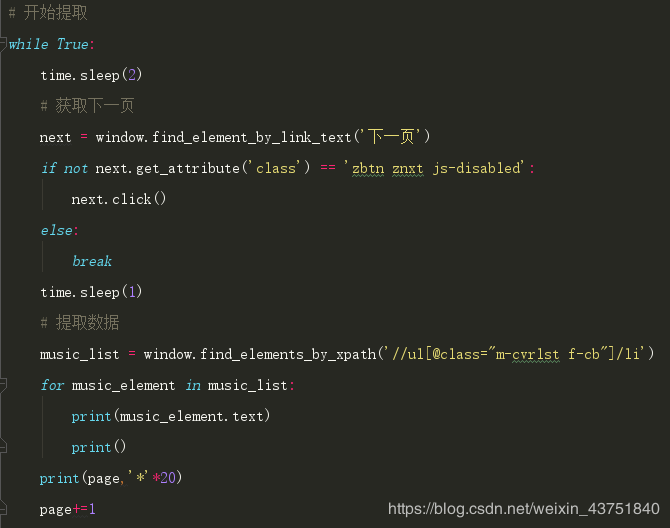
获取剩下的页数,这里在点击下一页之前需要设置一个延迟,不然会报错。
结果:
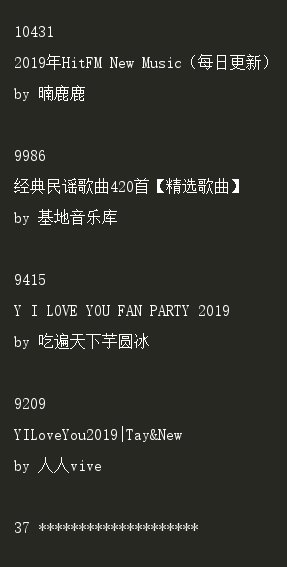
一共37页,爬取完毕后关闭浏览器
完整代码:
url = 'https://music.163.com/#/discover/playlist/'

from selenium import webdriver
import time
# 创建浏览器对象
window = webdriver.Chrome('./chromedriver')
window.get(url)
time.sleep(1)
# 切换到iframe窗口
iframe = window.find_element_by_id('g_iframe')
window.switch_to.frame(iframe)
music_list = window.find_elements_by_xpath('//ul[@class="m-cvrlst f-cb"]/li')
for music_element in music_list:
 print(music_element.text)
 print()
print('*'*20)

page = 1
# 开始提取
while True:
 time.sleep(2)
 # 获取下一页
 next = window.find_element_by_link_text('下一页')
 if not next.get_attribute('class') == 'zbtn znxt js-disabled':
  next.click()
 else:
  break
 time.sleep(1)
 # 提取数据
 music_list = window.find_elements_by_xpath('//ul[@class="m-cvrlst f-cb"]/li')
 for music_element in music_list:
  print(music_element.text)
  print()
 print(page,'*'*20)
 page+=1
# 退出浏览器
window.quit()
以上所述是小编给大家介绍的python selenium爬取网易云音乐歌单名详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!