pandas取出重复数据的方法

yipeiwu_com7年前Python基础

drop_duplicates为我们提供了数据去重的方法,那怎么得到哪些数据有重复呢?

实现步骤:

1、采用drop_duplicates对数据去两次重,一次将重复数据全部去除(keep=False)记为data1,另一次将重复数据保留一个(keep='first)记为data2;

2、求data1和data2的差集即可:data2.append(data1).drop_duplicates(keep=False)

以上这篇pandas取出重复数据的方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。

相关文章

对pandas将dataframe中某列按照条件赋值的实例讲解

在数据处理过程中,经常会出现对某列批量做某些操作,比如dataframe df要对列名为“values”做大于等于30设置为1,小于30设置为0操作,可以这样使用dataframe的ap...

Python如何import文件夹下的文件(实现方法)

Python如何import文件夹下的文件(实现方法)

Python的import包含文件功能就跟PHP的include类似,但更确切的说应该更像是PHP中的require,因为Python里的import只要目标不存在就报错程序无法往下执行...

python实现排序算法解析

python实现排序算法解析

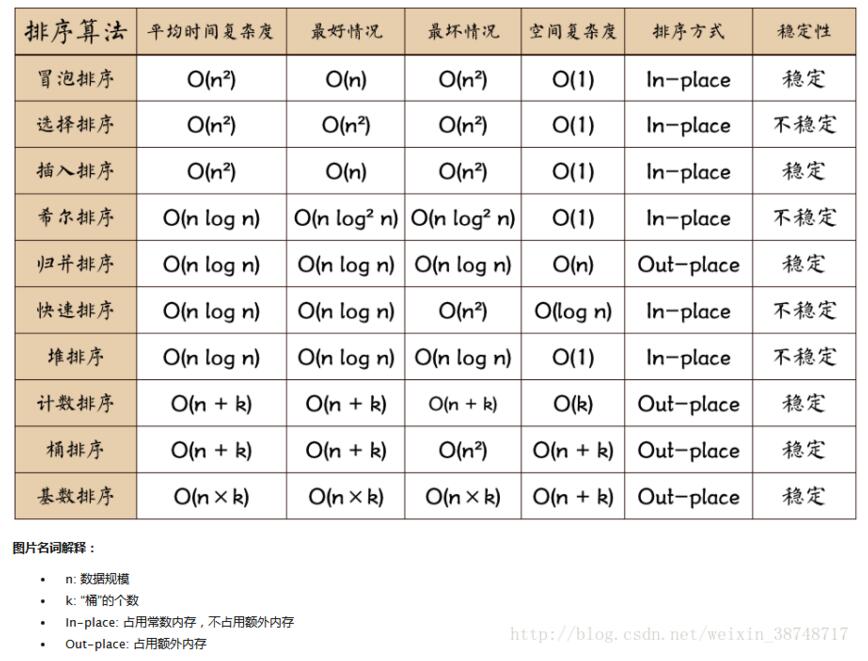
本文实例为大家分享了python实现排序算法的具体代码,供大家参考,具体内容如下 一、冒泡排序 def bububle_sort(alist): """冒泡排序(稳定|n^2m)...

Python中__call__用法实例

本文实例讲述了Python中__call__的用法,分享给大家供大家参考之用。具体方法如下: 先来看看如下示例代码: #call.py 一个class被载入的情况下。 class N...

python逐行读取文件内容的三种方法

方法一:复制代码 代码如下:f = open("foo.txt")          ...