python gensim使用word2vec词向量处理中文语料的方法
word2vec介绍
word2vec官网:https://code.google.com/p/word2vec/
- word2vec是google的一个开源工具,能够根据输入的词的集合计算出词与词之间的距离。
- 它将term转换成向量形式,可以把对文本内容的处理简化为向量空间中的向量运算,计算出向量空间上的相似度,来表示文本语义上的相似度。
- word2vec计算的是余弦值,距离范围为0-1之间,值越大代表两个词关联度越高。
- 词向量:用Distributed Representation表示词,通常也被称为“Word Representation”或“Word Embedding(嵌入)”。
简言之:词向量表示法让相关或者相似的词,在距离上更接近。
具体使用(处理中文)
收集语料
本文:亚马逊中文书评语料,12万+句子文本。
语料以纯文本形式存入txt文本。
注意:
理论上语料越大越好
理论上语料越大越好
理论上语料越大越好
重要的事情说三遍。
因为太小的语料跑出来的结果并没有太大意义。
分词
中文分词工具还是很多的,我自己常用的:
- 中科院NLPIR
- 哈工大LTP
- 结巴分词
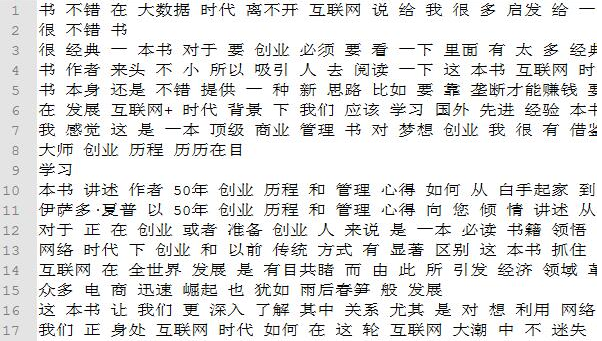
注意:分词文本将作为word2vec的输入文件。
分词文本示例
word2vec使用
python,利用gensim模块。
win7系统下在通常的python基础上gensim模块不太好安装,所以建议使用anaconda,具体参见: python开发之anaconda【以及win7下安装gensim】
直接上代码——
#!/usr/bin/env python
# -*- coding: utf-8 -*-

"""
功能:测试gensim使用,处理中文语料
时间:2016年5月21日 20:49:07
"""

from gensim.models import word2vec
import logging

# 主程序
logging.basicConfig(format='%(asctime)s : %(levelname)s : %(message)s', level=logging.INFO)
sentences = word2vec.Text8Corpus(u"C:\\Users\\lenovo\\Desktop\\word2vec实验\\亚马逊中文书评语料.txt") # 加载语料
model = word2vec.Word2Vec(sentences, size=200) # 默认window=5

# 计算两个词的相似度/相关程度
y1 = model.similarity(u"不错", u"好")
print u"【不错】和【好】的相似度为:", y1
print "--------\n"

# 计算某个词的相关词列表
y2 = model.most_similar(u"书", topn=20) # 20个最相关的
print u"和【书】最相关的词有:\n"
for item in y2:
  print item[0], item[1]
print "--------\n"

# 寻找对应关系
print u"书-不错,质量-"
y3 = model.most_similar([u'质量', u'不错'], [u'书'], topn=3)
for item in y3:
  print item[0], item[1]
print "--------\n"

# 寻找不合群的词
y4 = model.doesnt_match(u"书 书籍 教材 很".split())
print u"不合群的词:", y4
print "--------\n"

# 保存模型,以便重用
model.save(u"书评.model")
# 对应的加载方式
# model_2 = word2vec.Word2Vec.load("text8.model")

# 以一种C语言可以解析的形式存储词向量
model.save_word2vec_format(u"书评.model.bin", binary=True)
# 对应的加载方式
# model_3 = word2vec.Word2Vec.load_word2vec_format("text8.model.bin", binary=True)

if __name__ == "__main__":
  pass
运行结果
【不错】和【好】的相似度为: 0.790186663972
--------和【书】最相关的词有:
书籍 0.675163209438
书本 0.633386790752
确实 0.568059504032
教材 0.551493048668
正品 0.532882153988
没得说 0.529319941998
好 0.522468209267
据说 0.51004421711
图书 0.508755385876
挺 0.497194319963
新书 0.494331330061
很 0.490583062172
不错 0.476392805576
正版 0.460161447525
纸张 0.454929769039
可惜 0.450752496719
工具书 0.449723362923
的确 0.448629021645
商品 0.444284260273
纸质 0.443040698767
--------书-不错,质量-
精美 0.507958948612
总的来说 0.496103972197
材质 0.493623793125
--------不合群的词: 很
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。

