选择Python写网络爬虫的优势和理由
什么是网络爬虫?
网络爬虫是一个自动提取网页的程序,它为搜索引擎从万维网上下载网页,是搜索引擎的重要组成。传统爬虫从一个或若干初始网页的URL开始,获得初始网页上的URL,在抓取网页的过程中,不断从当前页面上抽取新的URL放入队列,直到满足系统的一定停止条件
爬虫有什么用?
- 做为通用搜索引擎网页收集器。(google,baidu)
- 做垂直搜索引擎.
- 科学研究:在线人类行为,在线社群演化,人类动力学研究,计量社会学,复杂网络,数据挖掘,等领域的实证研究都需要大量数据,网络爬虫是收集相关数据的利器。
- 偷窥,hacking,发垃圾邮件……
爬虫是搜索引擎的第一步也是最容易的一步
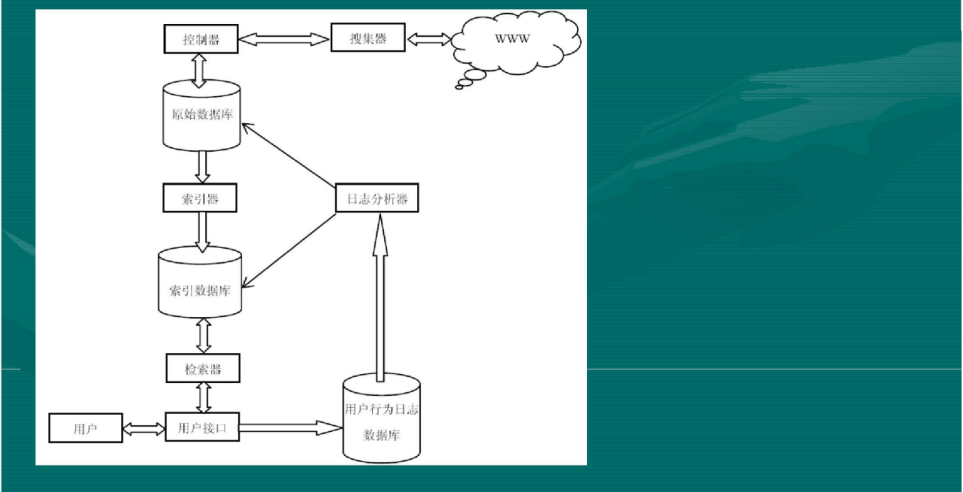
• 网页搜集
• 建立索引
• 查询排序
用什么语言写爬虫?
C,C++。高效率,快速,适合通用搜索引擎做全网爬取。缺点,开发慢,写起来又臭又长,例如:天网搜索源代码。
脚本语言:Perl, Python, Java, Ruby。简单,易学,良好的文本处理能方便网页内容的细致提取,但效率往往不高,适合对少量网站的聚焦爬取
C#?(貌似信息管理的人比较喜欢的语言)
为什么最终选择Python?
- 跨平台,对Linux和windows都有不错的支持。
- 科学计算,数值拟合:Numpy,Scipy
- 可视化:2d:Matplotlib(做图很漂亮), 3d: Mayavi2
- 复杂网络:Networkx
- 统计:与R语言接口:Rpy
- 交互式终端
- 网站的快速开发?
一个简单的Python爬虫
import urllib
import urllib.request

def loadPage(url,filename):
 """
 作用:根据url发送请求,获取html数据;
 :param url:
 :return:
 """
 request=urllib.request.Request(url)
 html1= urllib.request.urlopen(request).read()
 return html1.decode('utf-8')

def writePage(html,filename):
 """
 作用将html写入本地

 :param html: 服务器相应的文件内容
 :return:
 """
 with open(filename,'w') as f:
  f.write(html)
 print('-'*30)
def tiebaSpider(url,beginPage,endPage):
 """
 作用贴吧爬虫调度器,负责处理每一个页面url;
 :param url:
 :param beginPage:
 :param endPage:
 :return:
 """
 for page in range(beginPage,endPage+1):
  pn=(page - 1)*50
  fullurl=url+"&pn="+str(pn)
  print(fullurl)
  filename='第'+str(page)+'页.html'
  html= loadPage(url,filename)

  writePage(html,filename)


if __name__=="__main__":
 kw=input('请输入你要需要爬取的贴吧名:')
 beginPage=int(input('请输入起始页'))
 endPage=int(input('请输入结束页'))
 url='https://tieba.baidu.com/f?'
 kw1={'kw':kw}
 key = urllib.parse.urlencode(kw1)
 fullurl=url+key
 tiebaSpider(fullurl,beginPage,endPage)
以上就是关于为什么Python写网络爬虫的全部理由和知识点,感谢大家的阅读和对【听图阁-专注于Python设计】的支持。