python数据预处理之数据标准化的几种处理方式
何为标准化:
在数据分析之前,我们通常需要先将数据标准化(normalization),利用标准化后的数据进行数据分析。数据标准化也就是统计数据的指数化。数据标准化处理主要包括数据同趋化处理和无量纲化处理两个方面。数据同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。数据无量纲化处理主要解决数据的可比性。
几种标准化方法:
归一化Max-Min
min-max标准化方法是对原始数据进行线性变换。设minA和maxA分别为属性A的最小值和最大值,将A的一个原始值x通过min-max标准化映射成在区间[0,1]中的值x',其公式为:
新数据=(原数据-最小值)/(最大值-最小值)
这种方法能使数据归一化到一个区域内,同时不改变原来的数据结构。
实现中心化Z-Score
这种方法基于原始数据的均值(mean)和标准差(standard deviation)进行数据的标准化。将A的原始值x使用z-score标准化到x'。
z-score标准化方法适用于属性A的最大值和最小值未知的情况,或有超出取值范围的离群数据的情况。
新数据=(原数据-均值)/标准差
这种方法适合大多数类型数据,也是很多工具的默认标准化方法。标准化之后的数据是以0为均值,方差为以的正太分布。但是Z-Score方法是一种中心化方法,会改变原有数据的分布结构,不适合用于对稀疏数据做处理。
很多时候数据集会存在稀疏特征,表现为标准差小,很多元素值为0,最常见的稀疏数据集是用来做协同过滤的数据集,绝大部分数据都是0。对稀疏数据做标准化,不能采用中心化的方式,否则会破坏稀疏数据的结构。
用于稀疏数据的MaxAbs
最大值绝对值标准化(MaxAbs)即根据最大值的绝对值进行标准化,假设原转换的数据为x,新数据为x',那么x'=x/|max|,其中max为x锁在列的最大值。
该方法的数据区间为[-1, 1],也不破坏原数据结构的特点,因此也可以用于稀疏数据,一些稀疏矩阵。
针对离群点的RobustScaler
有些时候,数据集中存在离群点,用Z-Score进行标准化,但是结果不理想,因为离群点在标准化后丧失了利群特性。RobustScaler针对离群点做标准化处理,该方法对数据中心化的数据的缩放健壮性有更强的参数控制能力。
python实现
import numpy as np
import pandas as pd
from sklearn import preprocessing
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
import matplotlib.pyplot as plt
%matplotlib inline

# 导入数据
data = make_moons(n_samples=200, noise=10)[0]

#Z-Score标准化
#建立StandardScaler对象
zscore = preprocessing.StandardScaler()
# 标准化处理
data_zs = zscore.fit_transform(data)

#Max-Min标准化
#建立MinMaxScaler对象
minmax = preprocessing.MinMaxScaler()
# 标准化处理
data_minmax = minmax.fit_transform(data)

#MaxAbs标准化
#建立MinMaxScaler对象
maxabs = preprocessing.MaxAbsScaler()
# 标准化处理
data_maxabs = maxabs.fit_transform(data)

#RobustScaler标准化
#建立RobustScaler对象
robust = preprocessing.RobustScaler()
# 标准化处理
data_rob = robust.fit_transform(data)

# 可视化数据展示
# 建立数据集列表
data_list = [data, data_zs, data_minmax, data_maxabs, data_rob]
# 创建颜色列表
color_list = ['blue', 'red', 'green', 'black', 'pink']
# 创建标题样式
title_list = ['source data', 'zscore', 'minmax', 'maxabs', 'robust']

# 设置画幅
plt.figure(figsize=(9, 6))
# 循环数据集和索引
for i, dt in enumerate(data_list):
  # 子网格
  plt.subplot(2, 3, i+1)
  # 数据画散点图
  plt.scatter(dt[:, 0], dt[:, 1], c=color_list[i])
  # 设置标题
  plt.title(title_list[i])
# 图片储存
plt.savefig('xx.png')
# 图片展示
plt.show()
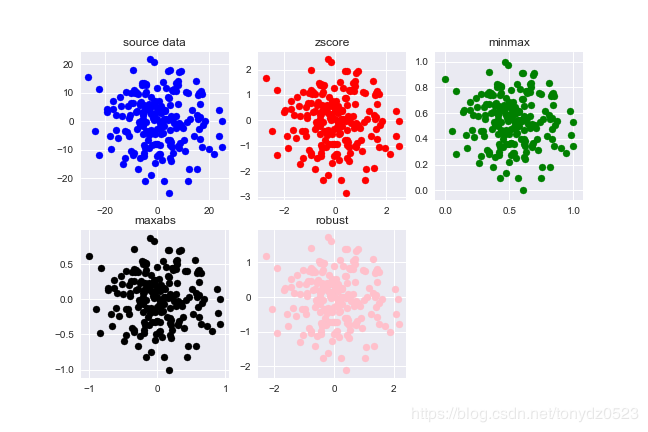
参考:
《python数据分析与数据化运营》 宋天龙
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。

