Python如何使用BeautifulSoup爬取网页信息
这篇文章主要介绍了Python如何使用BeautifulSoup爬取网页信息,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下
简单爬取网页信息的思路一般是
1、查看网页源码
2、抓取网页信息
3、解析网页内容
4、储存到文件
现在使用BeautifulSoup解析库来爬取刺猬实习Python岗位薪资情况
一、查看网页源码
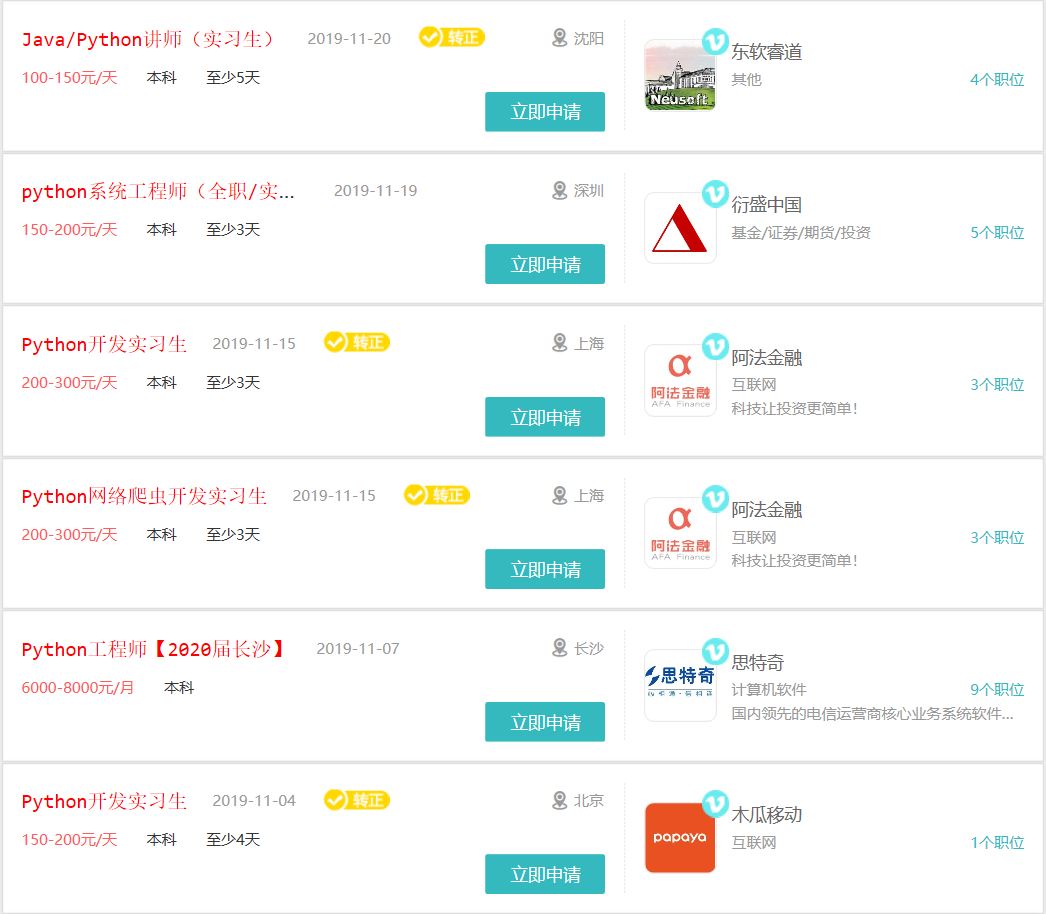
这部分是我们需要的内容,对应的源码为:
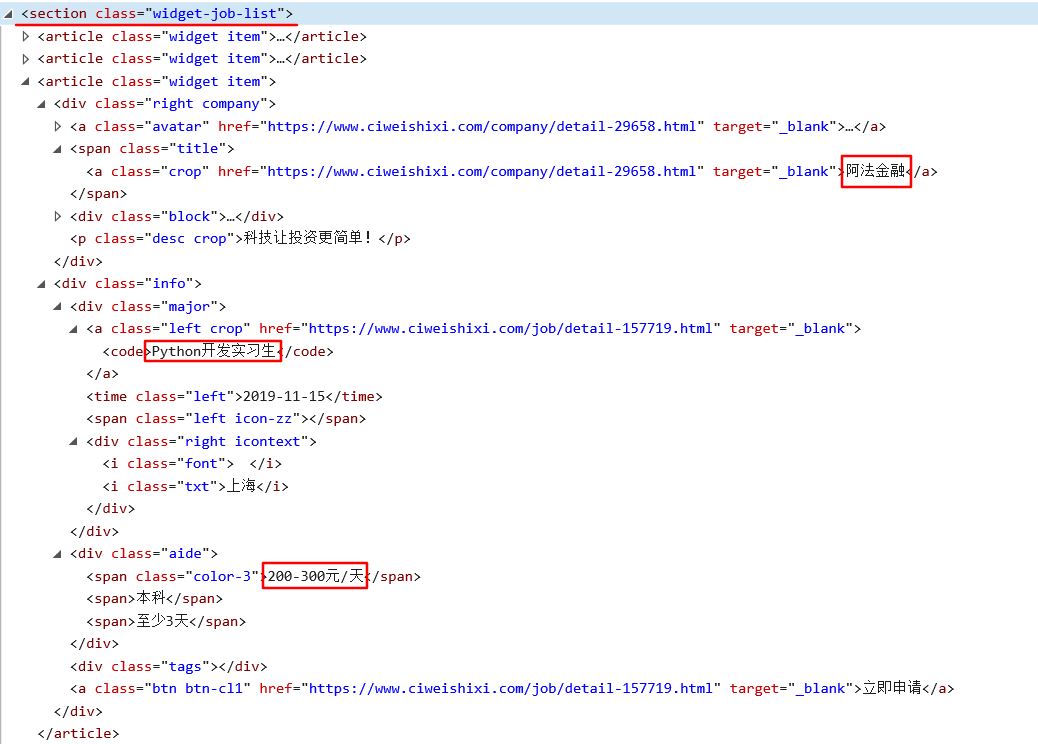
分析源码,可以得知:
1、岗位信息列表在<section class="widget-job-list">中
2、每条信息在<article class="widget item">中
3、对于每条信息,我们需要提取出的内容是 公司名称,职位, 薪资
二、抓取网页信息
使用request.get()抓取,返回的soup是网页的文本信息
def get_one_page(url):
  response = requests.get(url)
  soup = BeautifulSoup(response.text, "html.parser")
  return soup
三、解析网页内容
1、找到起始位置<section>
2、在<article>中匹配到各项信息
3、返回信息列表用以存储
def parse_page(soup):
  #待存储的信息列表
  return_list = []
  #起始位置
  grid = soup.find('section', attrs={"class": "widget-job-list"})
  if grid:
    #找到所有的岗位列表
    job_list = soup.find_all('article', attrs={"class": "widget item"})

    #匹配各项内容
    for job in job_list:
      #find()是寻找第一个符合的标签
      company = job.find('a', attrs={"class": "crop"}).get_text().strip()#返回类型为string,用strip()可以去除空白符,换行符
      title = job.find('code').get_text()
      salary = job.find('span', attrs={"class": "color-3"}).get_text()
      #将信息存到列表中并返回
      return_list.append(company + " " + title + " " + salary)
  return return_list
四、存储到文件
将列表信息存储到shixi.csv文件中
def write_to_file(content):
  #以追加的方式打开,设置编码格式防止乱码
  with open("shixi.csv", "a", encoding="gb18030")as f:
    f.write("\n".join(content))
五、爬取多页信息
在网页url中 可以看到最后的page代表的是页数信息
所以在main方法中传入一个page,然后循环运行main(page)就可以爬取多页信息了
def main(page):
  url = 'https://www.ciweishixi.com/search?key=python&page=' + str(page)
  soup = get_one_page(url)
  return_list = parse_page(soup)
  write_to_file(return_list)
if __name__ == "__main__":
  for i in range(4):
    main(i)
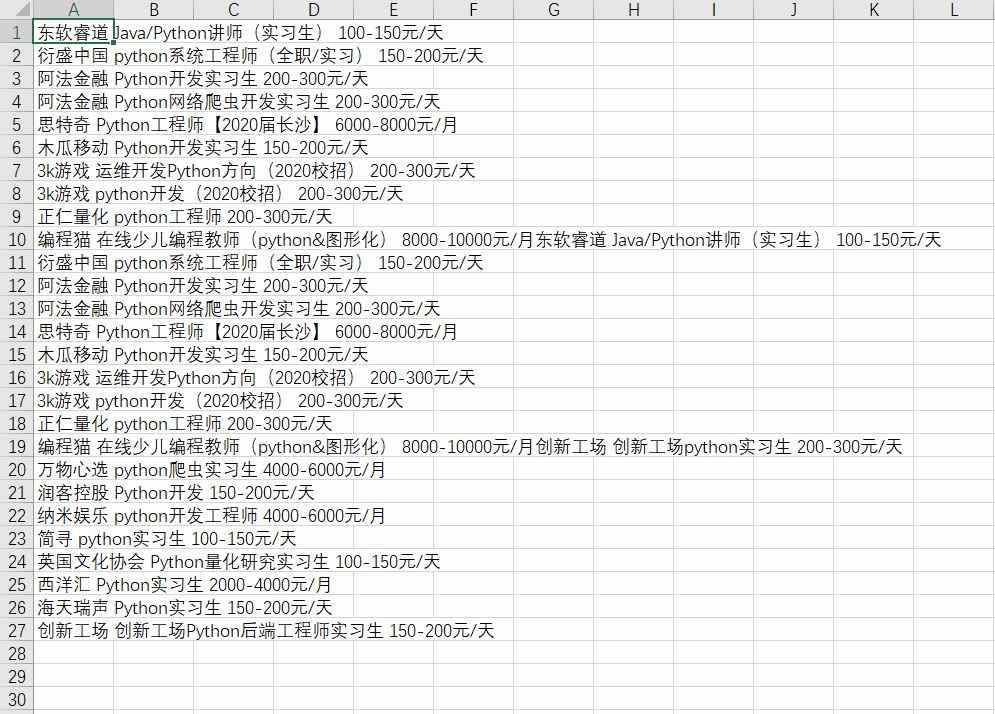
六、运行结果
七、完整代码
import requests
import re
from bs4 import BeautifulSoup

def get_one_page(url):
  response = requests.get(url)
  soup = BeautifulSoup(response.text, "html.parser")
  return soup

def parse_page(soup):
  #待存储的信息列表
  return_list = []
  #起始位置
  grid = soup.find('section', attrs={"class": "widget-job-list"})
  if grid:
    #找到所有的岗位列表
    job_list = soup.find_all('article', attrs={"class": "widget item"})

    #匹配各项内容
    for job in job_list:
      #find()是寻找第一个符合的标签
      company = job.find('a', attrs={"class": "crop"}).get_text().strip()#返回类型为string,用strip()可以去除空白符,换行符
      title = job.find('code').get_text()
      salary = job.find('span', attrs={"class": "color-3"}).get_text()
      #将信息存到列表中并返回
      return_list.append(company + " " + title + " " + salary)
  return return_list

def write_to_file(content):
  #以追加的方式打开,设置编码格式防止乱码
  with open("shixi.csv", "a", encoding="gb18030")as f:
    f.write("\n".join(content))
def main(page):
  url = 'https://www.ciweishixi.com/search?key=python&page=' + str(page)
  soup = get_one_page(url)
  return_list = parse_page(soup)
  write_to_file(return_list)
if __name__ == "__main__":
  for i in range(4):
    main(i)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。