python爬虫模拟浏览器的两种方法实例分析
本文实例讲述了python爬虫模拟浏览器的两种方法。分享给大家供大家参考,具体如下:
爬虫爬取网站出现403,因为站点做了防爬虫的设置
一、Herders 属性
爬取CSDN博客
import urllib.request
url = "http://blog.csdn.net/hurmishine/article/details/71708030"file = urllib.request.urlopen(url)
爬取结果
urllib.error.HTTPError: HTTP Error 403: Forbidden
这就说明CSDN做了一些设置,来防止别人恶意爬取信息
所以接下来,我们需要让爬虫模拟成浏览器
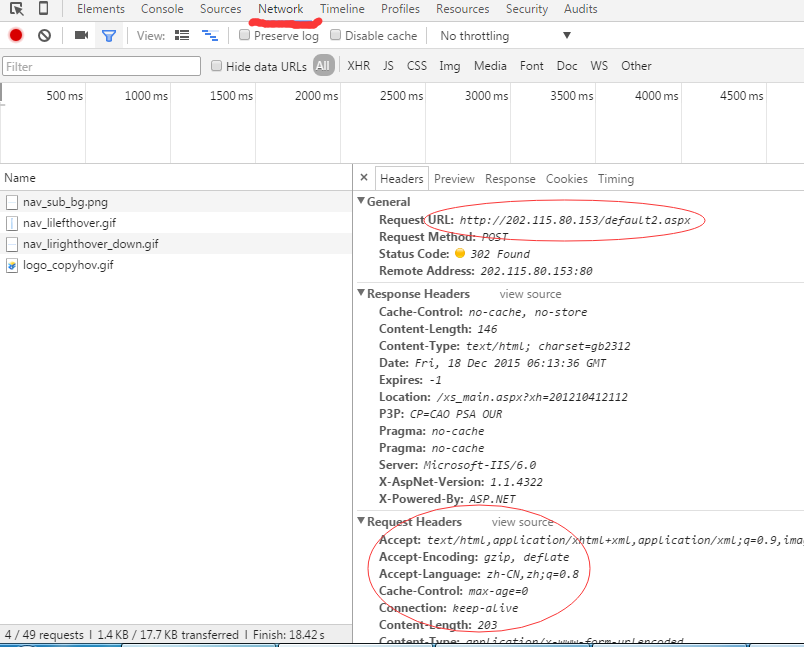
任意打开一个网页,比如打开百度,然后按F12,此时会出现一个窗口,我们切换到Network标签页,然后点击刷新网站,选中弹出框左侧的“www.baidu.com”,即下图所示:
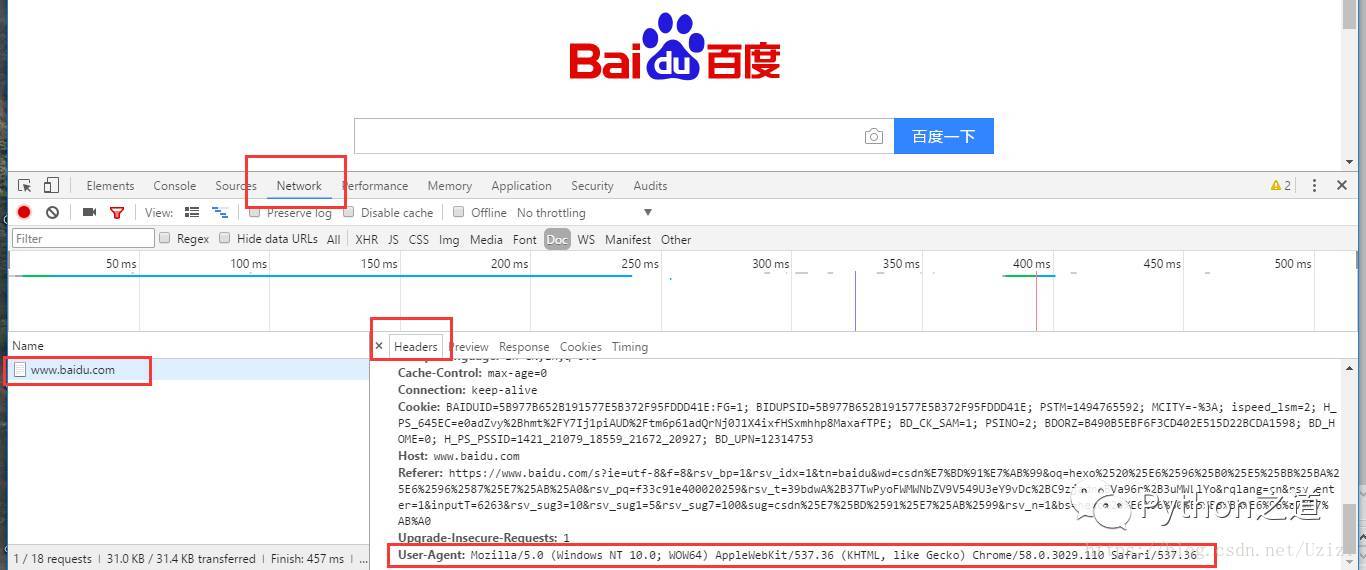
往下拖动 我们会看到“User-Agent”字样的一串信息,没错 这就是我们想要的东西。我们将其复制下来。
此时我们得到的信息是:”Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36”
接下来我们可以用两种方式来模拟浏览器访问网页。
二、方法1:使用build_opener()修改报头
由于urlopen()不支持一些HTTP的高级功能,所以我们需要修改报头。可以使用urllib.request.build_opener()进行,我们修改一下上面的代码:
import urllib.request
url = "http://blog.csdn.net/hurmishine/article/details/71708030"headers = ("User-Agent","Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36")
opener = urllib.request.build_opener()
opener.addheaders = [headers]
data = opener.open(url).read()
print(data)
上面代码中我们先定义一个变量headers来储存User-Agent信息,定义的格式是(“User-Agent”,具体信息)
具体信息我们上面已经获取到了,这个信息获取一次即可,以后爬取其他网站也可以用,所以我们可以保存下来,不用每次都F12去找了。
然后我们用urllib.request.build_opener()创建自定义的opener对象并赋值给opener,然后设置opener的addheaders,就是设置对应的头信息,格式为:“opener(对象名).addheaders = [头信息(即我们储存的具体信息)]”,设置好后我们就可以使用opener对象的open()方法打开对应的网址了。格式:“opener(对象名).open(url地址)”打开后我们可以使用read()方法来读取对应数据,并赋值给data变量。
得到输出结果
b'\r\n<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd">\r\n \r\n <html xmlns="http://www.w3.org/1999/xhtml">\r\n \r\n<head> \r\n\r\n <link rel="canonical" href="http://blog.csdn.net/hurmishine/article/details/71708030" rel="external nofollow" /> ...
三、方法2:使用add_header()添加报头
除了上面的这种方法,还可以使用urllib.request.Request()下的add_header()实现浏览器的模拟。
先上代码
import urllib.request
url = "http://blog.csdn.net/hurmishine/article/details/71708030"req = urllib.request.Request(url)
req.add_header('User-Agent','Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36')
data = urllib.request.urlopen(req).read()
print(data)
好,我们来分析一下。
导入包,定义url地址我们就不说了,我们使用urllib.request.Request(url)创建一个Request对象,并赋值给变量req,创建Request对象的格式:urllib.request.Request(url地址)
随后我们使用add_header()方法添加对应的报头信息,格式:Request(对象名).add_header(‘对象名','对象值')
现在我们已经设置好了报头,然后我们使用urlopen()打开该Request对象即可打开对应的网址,多以我们使用
data = urllib.request.urlopen(req).read()打开了对应的网址,并读取了网页内容,并赋值给data变量。
以上,我们使用了两种方法实现了爬虫模拟浏览器打开网址,并获取网址的内容信息,避免了403错误。
值得我们注意的是,方法1中使用的是addheaders()方法,方法2中使用的是add_header()方法,注意末尾有无s以及有无下划线的区别
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。