Python CSV文件模块的使用案例分析
本文实例讲述了Python CSV文件模块的使用。分享给大家供大家参考,具体如下:
1、CSV模块使用流程
1、导入模块
impport CSV
2、打开文件(xxx.csv)
with open('xxx.csv','a',encoding='utf-8') as f:
- 1、a和 a+ ‘追加'功能
a 追加写
a+ 追加写读(先写后读)
- 2、r 和 r+
r 只读
r+读写,先读后写
- 3、w,w+
w 只写
w+写读 先写后读
3、初始化写入对象
writer = csv.wirter()
4、写入数据
writer.writerow(['孙悟空', '兰陵王'])
案例:
猫眼电影top10榜单的爬取
1、网址:url
2、目标:爬取自己想要的文件
3、保存本地:csv文件
4、步骤
- 1、找url规律
第一页:https://maoyan.com/board/4?offset=0
第4页:https://maoyan.com/board/4?offset=30
第n页:offset=(n-1)*10
- 2、写正则表达式
'<div class="movie-item-info".*?title="(.*?)".*?class="star">(.* ?)</p>.*?class="releasetime">(.*?)</p>',re.S
练习:爬取猫王top10信息
from urllib import request
import re
import time
import csv
class MaoyanSpider(object):
   def __init__(self):
    self.headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; rv:2.0.1) Gecko/20100101 Firefox/4.0.1"}
    self.page = 1
    # 用来计数
   def get_page(self, url):
    req = request.Request(url, headers=self.headers)
    res = request.urlopen(req)
    html = res.read().decode('utf-8')
    # 直接调用解析函数
    self.parse_page(html)
   def parse_page(self,html):
     p=re.compile('<div class="movie-item-info">.*?title="(.*?)".*?class="star">(.*?)</p>.*?class="releasetime">(.*?)</p>',re.S)
     #p=re.compile('<div class="movie-item-info">.*?title="(.*?)".*?class="star">(.* ?)</p>.*?class="releasetime">(.*?)</p>',re.S)
     r_list = p.findall(html)
     # 直接调用保存函数
     # r_list:[('霸王别姬','张国荣','1993'),(),()]
     self.write_csv(r_list)
  # 保存数据函数
   def  write_csv(self,r_list):
     with open('猫眼电影top10.csv','a') as f:
      writer = csv.writer(f)
      # 依次写入每个电影信息
      for r_t in r_list:
        film = [
          r_t[0].strip(),
          r_t[1].strip(),
          r_t[2].strip()
          ]
        writer.writerow(film)
  #主函数
   def work_om(self):
     for pn in range(0,41,10):
      url = 'https://maoyan.com/board/4?offset=%s'%str(pn)
      self.get_page(url)
      print('第%d页爬取成功'%self.page)
      self.page += 1
      time.sleep(4)
if __name__ =='__main__':
  begin = time.time()
  spider = MaoyanSpider()
  spider.work_om()
  end = time.time()
  print("执行时间%.2f"%(end - begin))
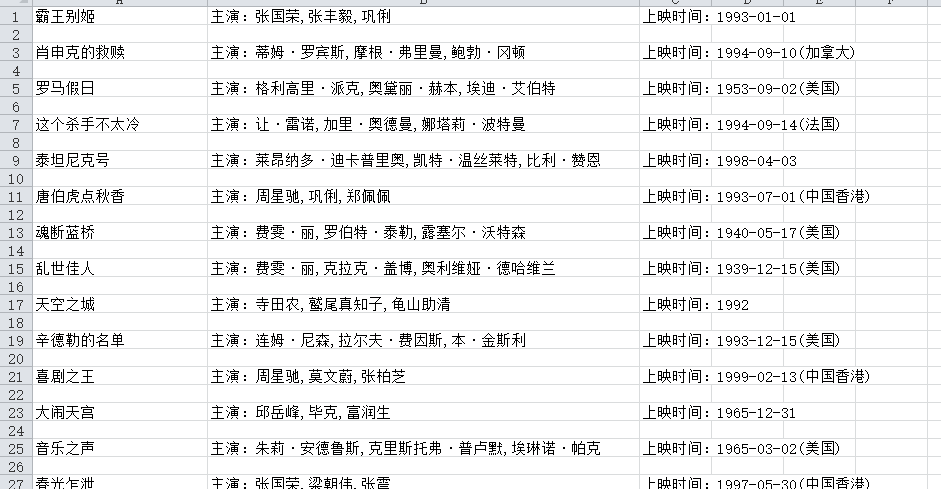
运行截图:
更多Python相关内容感兴趣的读者可查看本站专题:《Python操作Excel表格技巧总结》、《Python编码操作技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。