Pytorch 多块GPU的使用详解
注:本文针对单个服务器上多块GPU的使用,不是多服务器多GPU的使用。
在一些实验中,由于Batch_size的限制或者希望提高训练速度等原因,我们需要使用多块GPU。本文针对Pytorch中多块GPU的使用进行说明。
1. 设置需要使用的GPU编号
import os

os.environ["CUDA_VISIBLE_DEVICES"] = "0,4"
ids = [0,1]
比如我们需要使用第0和第4块GPU,只用上述三行代码即可。
其中第二行指程序只能看到第1块和第4块GPU;
第三行的0即为第二行中编号为0的GPU;1即为编号为4的GPU。
2.更改网络,可以理解为将网络放入GPU
class CNN(nn.Module):
  def __init__(self):
    super(CNN,self).__init__()
    self.conv1 = nn.Sequential(
    ......
    )

    ......

    self.out = nn.Linear(Liner_input,2)

  ......

  def forward(self,x):
    x = self.conv1(x)
    ......
    output = self.out(x)
    return output,x

cnn = CNN()

# 更改,.cuda()表示将本存储到CPU的网络及其参数存储到GPU!
cnn.cuda()
3. 更改输出数据(如向量/矩阵/张量):
for epoch in range(EPOCH):
  epoch_loss = 0.
  for i, data in enumerate(train_loader2):
    image = data['image'] # data是字典,我们需要改的是其中的image

    #############更改!!!##################
    image = Variable(image).float().cuda()
    ############################################

    label = inputs['label']
    #############更改!!!##################
    label = Variable(label).type(torch.LongTensor).cuda()
    ############################################
    label = label.resize(BATCH_SIZE)
    output = cnn(image)[0]
    loss = loss_func(output, label)  # cross entropy loss
    optimizer.zero_grad()      # clear gradients for this training step
    loss.backward()         # backpropagation, compute gradients
    optimizer.step()
    ... ...
4. 更改其他CPU与GPU冲突的地方
有些函数必要在GPU上完成,例如将Tensor转换为Numpy,就要使用data.cpu().numpy(),其中data是GPU上的Tensor。
若直接使用data.numpy()则会报错。除此之外,plot等也需要在CPU中完成。如果不是很清楚哪里要改的话可以先不改,等到程序报错了,再哪里错了改哪里,效率会更高。例如:
  ... ...
    #################################################
    pred_y = torch.max(test_train_output, 1)[1].data.cpu().numpy()

    accuracy = float((pred_y == label.cpu().numpy()).astype(int).sum()) / float(len(label.cpu().numpy()))
假如不加.cpu()便会报错,此时再改即可。
5. 更改前向传播函数,从而使用多块GPU
以VGG为例:
class VGG(nn.Module):

  def __init__(self, features, num_classes=2, init_weights=True):
    super(VGG, self).__init__()
... ...

  def forward(self, x):
    #x = self.features(x)
    #################Multi GPUS#############################
    x = nn.parallel.data_parallel(self.features,x,ids)
    x = x.view(x.size(0), -1)
    # x = self.classifier(x)
    x = nn.parallel.data_parallel(self.classifier,x,ids)
    return x
... ...
然后就可以看运行结果啦,nvidia-smi查看GPU使用情况:
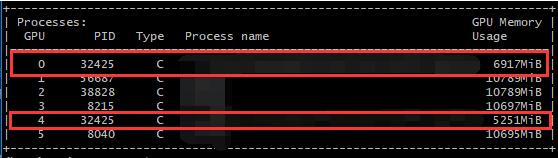
可以看到0和4都被使用啦
以上这篇Pytorch 多块GPU的使用详解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。