Python实现bilibili时间长度查询的示例代码
说明:最近在B站看一些材料力学视频时候,感觉有一些分集狂魔的分集真的很恐怖,有的甚至上百集,因此决定写个小脚本每次分析下到底这个系列视频到底有多长。
好了,下面是分析过程:
第一步当然是打开一个视频
接着第二部右键查看源代码
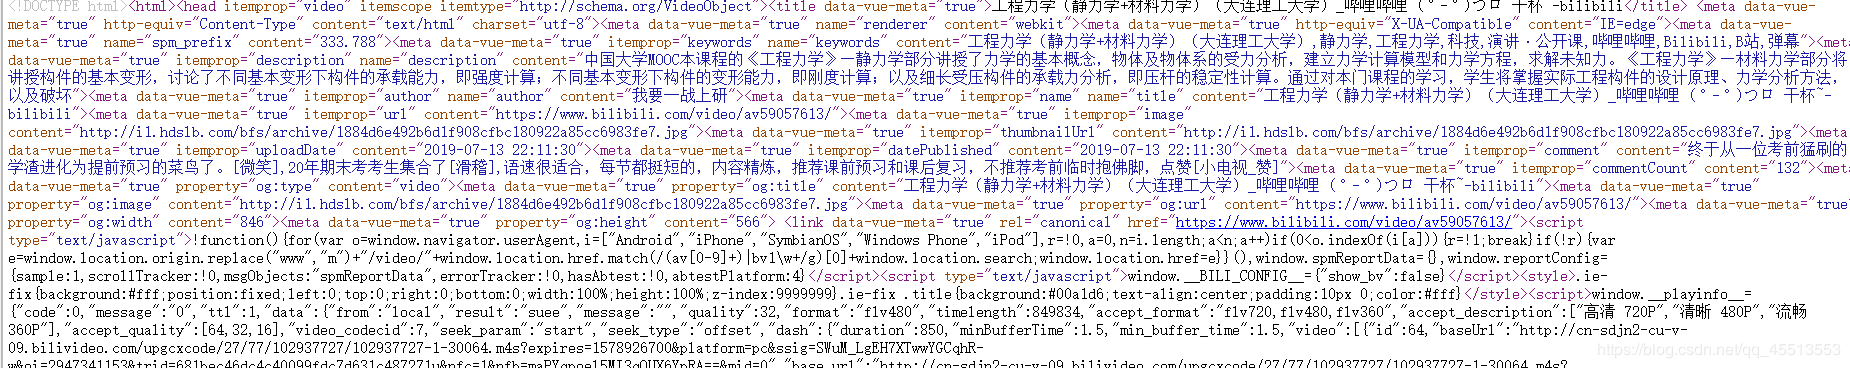
既然我们是要查找时间,然后我就搜索time相关的,哟!,还真有,其中有个timelength,英语有点基础的应该也能读出,这不就是时长的意思。哈哈哈,这也太简单了,但是又发现高兴太早了,这个经过不论是除60还是除3600都无法得到需要的结果,就在这时,突然一个乘法口诀蹦了出来,这个timelength的前几位除60不就是要的结果吗,这样我们就顺利找到了
接下来又出现一个问题,这一个页面的是出来的,但是一共有多少总不能每次都要输入吧,接下来就继续分析
看了一下,一共有93集,但是直接搜肯定是不行的,毕竟搜了一下有一百多个。看来要另想出路了。
想到刚才的timelength参数是使用的类似字典类型,那我接按字典的格式搜不也行吗,
这下行了,搜到的第一个就是,哈哈,我都有些自负了,这也太简单了,这个问题再次被顺利解决了。
最后是代码,小白写,大佬勿喷,如有不足还请谅解,源码已上传至GitHub
import requests
import re
import pygame
import time

header = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) '
            'Chrome/74.0.3729.157 ''Safari/537.36 '}


class Bili(object):
  def __init__(self, url):
    self.url = url
    self.max_page = 0
    self.the_time = list()
    self.sum_time = 0
    self.b_url = 'https://www.bilibili.com/video/av' + re.search(r'av(\d+)', url).group(1) + '?p='

  @staticmethod
  def get_html(acp_url):
    try:
      r = requests.get(acp_url, headers=header)
      r.raise_for_status()
      r.encoding = r.apparent_encoding
      return r.text
    except Exception as result:
      print("get_html:", result)
      return ""

  def parse_max_page(self):
    self.max_page = int(re.findall(r'videos":(.+?),', self.get_html(self.url))[0])

  def parse_time(self, se_url):
    text = self.get_html(se_url)
    single_time = re.findall(r'"timelength":(\d+),', text)[0][:-3]
    return single_time

  def get_time(self):
    for i in range(self.max_page + 1):
      s_url = self.b_url + str(i)
      ret = self.parse_time(s_url)
      self.the_time.append(ret)
      print("第%d页 time=%s" % (i, ret))
    for each in self.the_time:
      self.sum_time += int(each)
    print("sum_time:%.3s h" % str(self.sum_time / 60))

  def main(self):
    self.parse_max_page()
    self.get_time()


if __name__ == '__main__':
  i_url = input("请输入链接地址[要以+结尾]:")
  Bili(i_url).main()
说明
这句i_url = input("请输入链接地址[要以+结尾]:")由于本身编译器的原因,直接回车会跳转
GitHub地址:https://github.com/easyprogramer/My_Python_Spider/tree/master
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。