Python3 实现爬取网站下所有URL方式
获取首页元素信息:
目标 test_URL:http://www.xxx.com.cn/
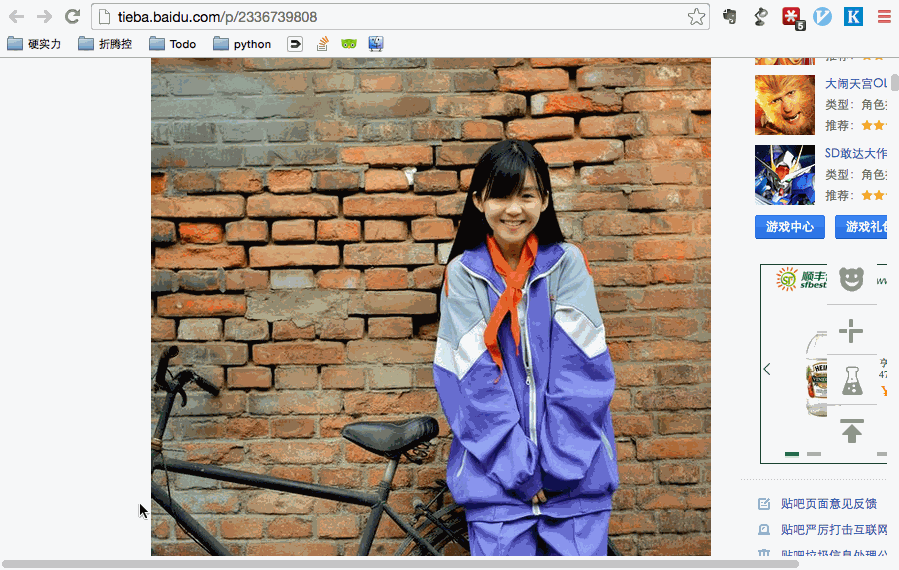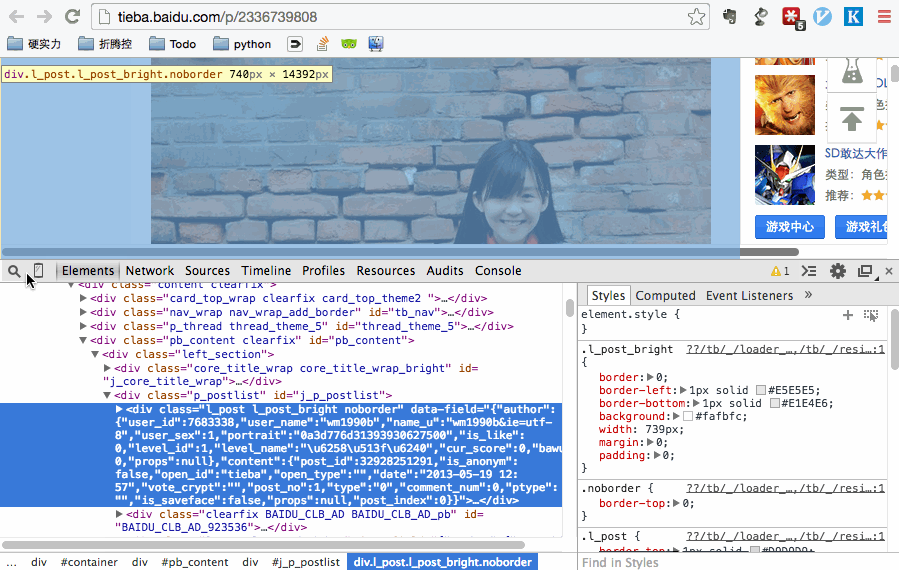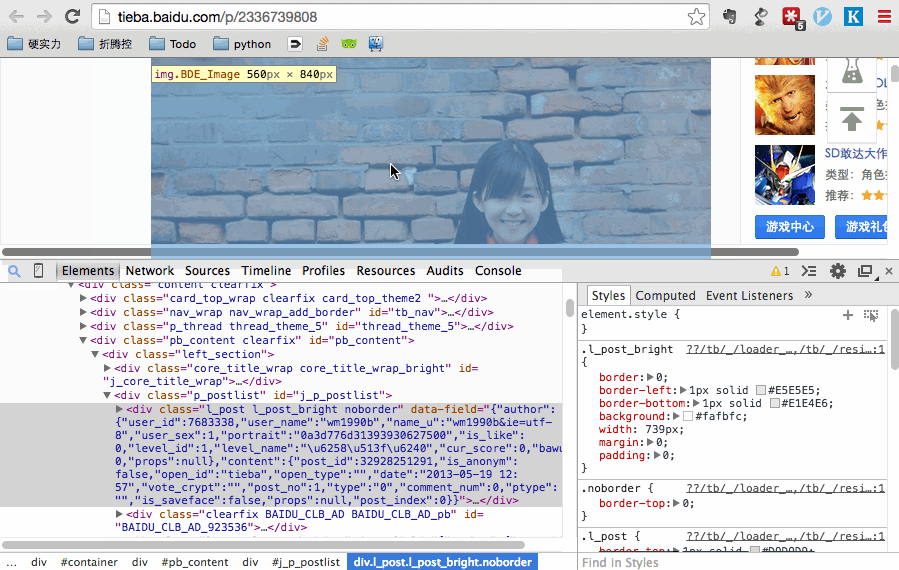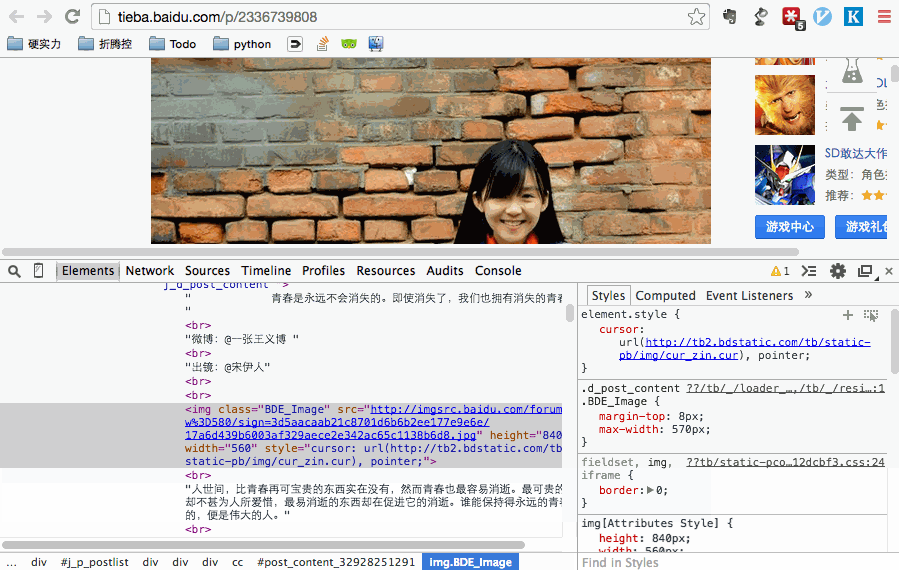
首先检查元素,a 标签下是我们需要爬取得链接,通过获取链接路径,定位出我们需要的信息
soup = Bs4(reaponse.text, "lxml")
urls_li = soup.select("#mainmenu_top > div > div > ul > li")
首页的URL链接获取:
完成首页的URL链接获取,具体代码如下:
'''
遇到不懂的问题?Python学习交流群:821460695满足你的需求,资料都已经上传群文件,可以自行下载!
'''
def get_first_url():
  list_href = []
  reaponse = requests.get("http://www.xxx.com.cn", headers=headers)
  soup = Bs4(reaponse.text, "lxml")
  urls_li = soup.select("#mainmenu_top > div > div > ul > li")
  for url_li in urls_li:
    urls = url_li.select("a")
    for url in urls:
      url_href = url.get("href")
      list_href.append(head_url+url_href)
      out_url = list(set(list_href))
  for reg in out_url:
    print(reg)
遍历第一次返回的结果:
从第二步获取URL的基础上,遍历请求每个页面,获取页面中的URL链接,过滤掉不需要的信息
具体代码如下:
def get_next_url(urllist):
  url_list = []
  for url in urllist:
    response = requests.get(url,headers=headers)
    soup = Bs4(response.text,"lxml")
    urls = soup.find_all("a")
    if urls:
      for url2 in urls:
        url2_1 = url2.get("href")
        if url2_1:
          if url2_1[0] == "/":
            url2_1 = head_url + url2_1
            url_list.append(url2_1)
            if url2_1[0:24] == "http://www.xxx.com.cn":
              url2_1 = url2_1
              url_list.append(url2_1)
            else:
              pass
          else:
            pass
        else:
          pass
    else:
      pass
  url_list2 = set(url_list)
  for url_ in url_list2:
    res = requests.get(url_)
    if res.status_code ==200:
      print(url_)
  print(len(url_list2))
递归循环遍历:
递归实现爬取所有url,在get_next_url()函数中调用自身,代码如下:
get_next_url(url_list2)
全部代码如下:
import requests
from bs4 import BeautifulSoup as Bs4

head_url = "http://www.xxx.com.cn"
headers = {
  "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36"
}
def get_first_url():
  list_href = []
  reaponse = requests.get(head_url, headers=headers)
  soup = Bs4(reaponse.text, "lxml")
  urls_li = soup.select("#mainmenu_top > div > div > ul > li")
  for url_li in urls_li:
    urls = url_li.select("a")
    for url in urls:
      url_href = url.get("href")
      list_href.append(head_url+url_href)
      out_url = list(set(list_href))
  return out_url


def get_next_url(urllist):
  url_list = []
  for url in urllist:
    response = requests.get(url,headers=headers)
    soup = Bs4(response.text,"lxml")
    urls = soup.find_all("a")
    if urls:
      for url2 in urls:
        url2_1 = url2.get("href")
        if url2_1:
          if url2_1[0] == "/":
            url2_1 = head_url + url2_1
            url_list.append(url2_1)
            if url2_1[0:24] == "http://www.xxx.com.cn":
              url2_1 = url2_1
              url_list.append(url2_1)
            else:
              pass
          else:
            pass
        else:
          pass
    else:
      pass
  url_list2 = set(url_list)
  for url_ in url_list2:
    res = requests.get(url_)
    if res.status_code ==200:
      print(url_)
  print(len(url_list2))
  get_next_url(url_list2)


if __name__ == "__main__":
  urllist = get_first_url()
  get_next_url(urllist)
以上这篇Python3 实现爬取网站下所有URL方式就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。