Python爬豆瓣电影实例
文件结构
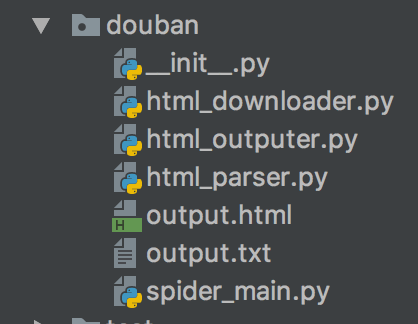
html_downloader.py - 下载网页html内容
#!/usr/bin/python
# -*- coding: UTF-8 -*-
import urllib2

class HtmlDownloader(object):

  def downlod(self, url):
    if url is None:
      return None
    response = urllib2.urlopen(url)
    if response.getcode() != 200:
      return None
    return response.read()
html_outputer.py - 输出结果到文件中
#!/usr/bin/python
# -*- coding: UTF-8 -*-


class HtmlOutputer(object):

  def collect_data(self, movie_data):
    if movie_data is None:
      return
    fout = open('output.html', 'a+')
    for data in movie_data:
      print data['name'] + '|', data['rate'] + '|', data['actor'], '\n'
      fout.write('%s,' % data['name'].encode('utf-8'))
      fout.write('%s,' % data['rate'])
      fout.write('%s\n' % data['actor'].encode('utf-8'))
    fout.close()
html_parser.py: 解析器:解析html的dom树
#!/usr/bin/python
# -*- coding: UTF-8 -*-
from bs4 import BeautifulSoup


class HtmlParser(object):

  def __init__(self):
    pass

  def parser_html(self, cnt):
    if cnt is None:
      return
    soup = BeautifulSoup(cnt, 'html.parser', from_encoding='utf-8')
    # movie_name, movie_desc, movie_rate =
    return self.get_movie_names(soup)

  def get_movie_names(self, soup):
    movie_data = []
    movie_all = soup.find('div', class_='article').find_next('table').find_next_sibling('div').find_next_sibling('div').find_all('table')
    count = 1
    for movie_one in movie_all:
      movie_data.append(self.get_movie_name(movie_one))
      # if count > 2:
      #   break
      count += 1
    return movie_data

  def get_movie_name(self, cnt):
    info = {}
    soup = BeautifulSoup(str(cnt), 'html.parser', from_encoding='utf-8')
    movie_one = soup.find('tr', class_='item').find_next('td').find_next_sibling('td').find('div', class_='pl2')
    info['name'] = movie_one.find('a').get_text().replace("\n", "").replace(" ", "")
    info['actor'] = movie_one.find('p', class_='pl').get_text().replace("\n", "").replace(" ", "")
    info['rate'] = movie_one.find('div', class_='star clearfix').find('span', class_='rating_nums').get_text()
    return info
spider_main.py - 主函数
#!/usr/bin/python
# -*- coding: UTF-8 -*-
import html_parser, html_outputer, html_downloader


class SpiderMain(object):

  def __init__(self):
    self.parser = html_parser.HtmlParser()
    self.outputer = html_outputer.HtmlOutputer()
    self.downloader = html_downloader.HtmlDownloader()

  def craw(self, url):
    html_cnt = self.downloader.downlod(url)
    movie_data = self.parser.parser_html(html_cnt)
    self.outputer.collect_data(movie_data)


if __name__ == '__main__':
  url = 'https://movie.douban.com/tag/2017?start=100&type=T'
  spider = SpiderMain()
  spider.craw(url)
综述
其实就是使用了urllib2和BeautifulSoup库,没啥好说的,你也可以直接改url,然后更改html_parser.py文件来满足你自己的爬虫需求。当前也可以更改html_outputer.py来定义保存格式,目前是csv。