对DataFrame数据中的重复行,利用groupby累加合并的方法详解

yipeiwu_com7年前Python基础

pandas读取一组数据,可能存在重复索引,虽然可以利用drop_duplicate直接删除,但是会删除重要信息。

比如同一ID用户,多次登录学习时间。要计算该用户总共‘'学习时间‘',就要把重复的ID的‘'学习时间‘'累加。

可以结合groupby和sum函数完成该操作。

实例如下:

新建一个DataFrame,计算每个 id 的总共学习时间。其中 id 为one/two的存在重复学习时间。先利用 groupby 按照键 id 分组,然后利用sum()函数求和,即可得到每个id的总共学习时间。
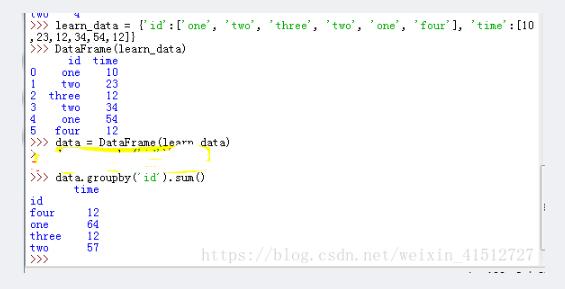
DataFrame数据中的重复行,利用groupby累加合并

以上这篇对DataFrame数据中的重复行,利用groupby累加合并的方法详解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

python简单获取数组元素个数的方法

本文实例讲述了python简单获取数组元素个数的方法。分享给大家供大家参考。具体如下: 复制代码 代码如下:mySeq = [1,2,3,4,5]  print len(my...

python发送告警邮件脚本

python发送告警邮件脚本

python脚本为敏捷开发脚本,在zabbix监控也起到重要作用,以下是使用python脚本发送告警邮件配置方法。 脚本如下: #!/usr/bin/python #coding:u...

Python玩转Excel的读写改实例

摘要: 利用xlrd读取excel 利用xlwt写excel 利用xlutils修改excel 利用xlrd读取excel 先需要在命令行中pip install xlr...

pandas Dataframe行列读取的实例

如下所示: import matplotlib.pyplot as plt import tkinter import numpy as np import pandas as...

Python的Django应用程序解决AJAX跨域访问问题的方法

引子 使用Django在服务器端写了一个API,返回一个JSON数据。使用Ajax调用该API: <!DOCTYPE HTML> <html> <he...