Python2和3字符编码的区别知识点整理
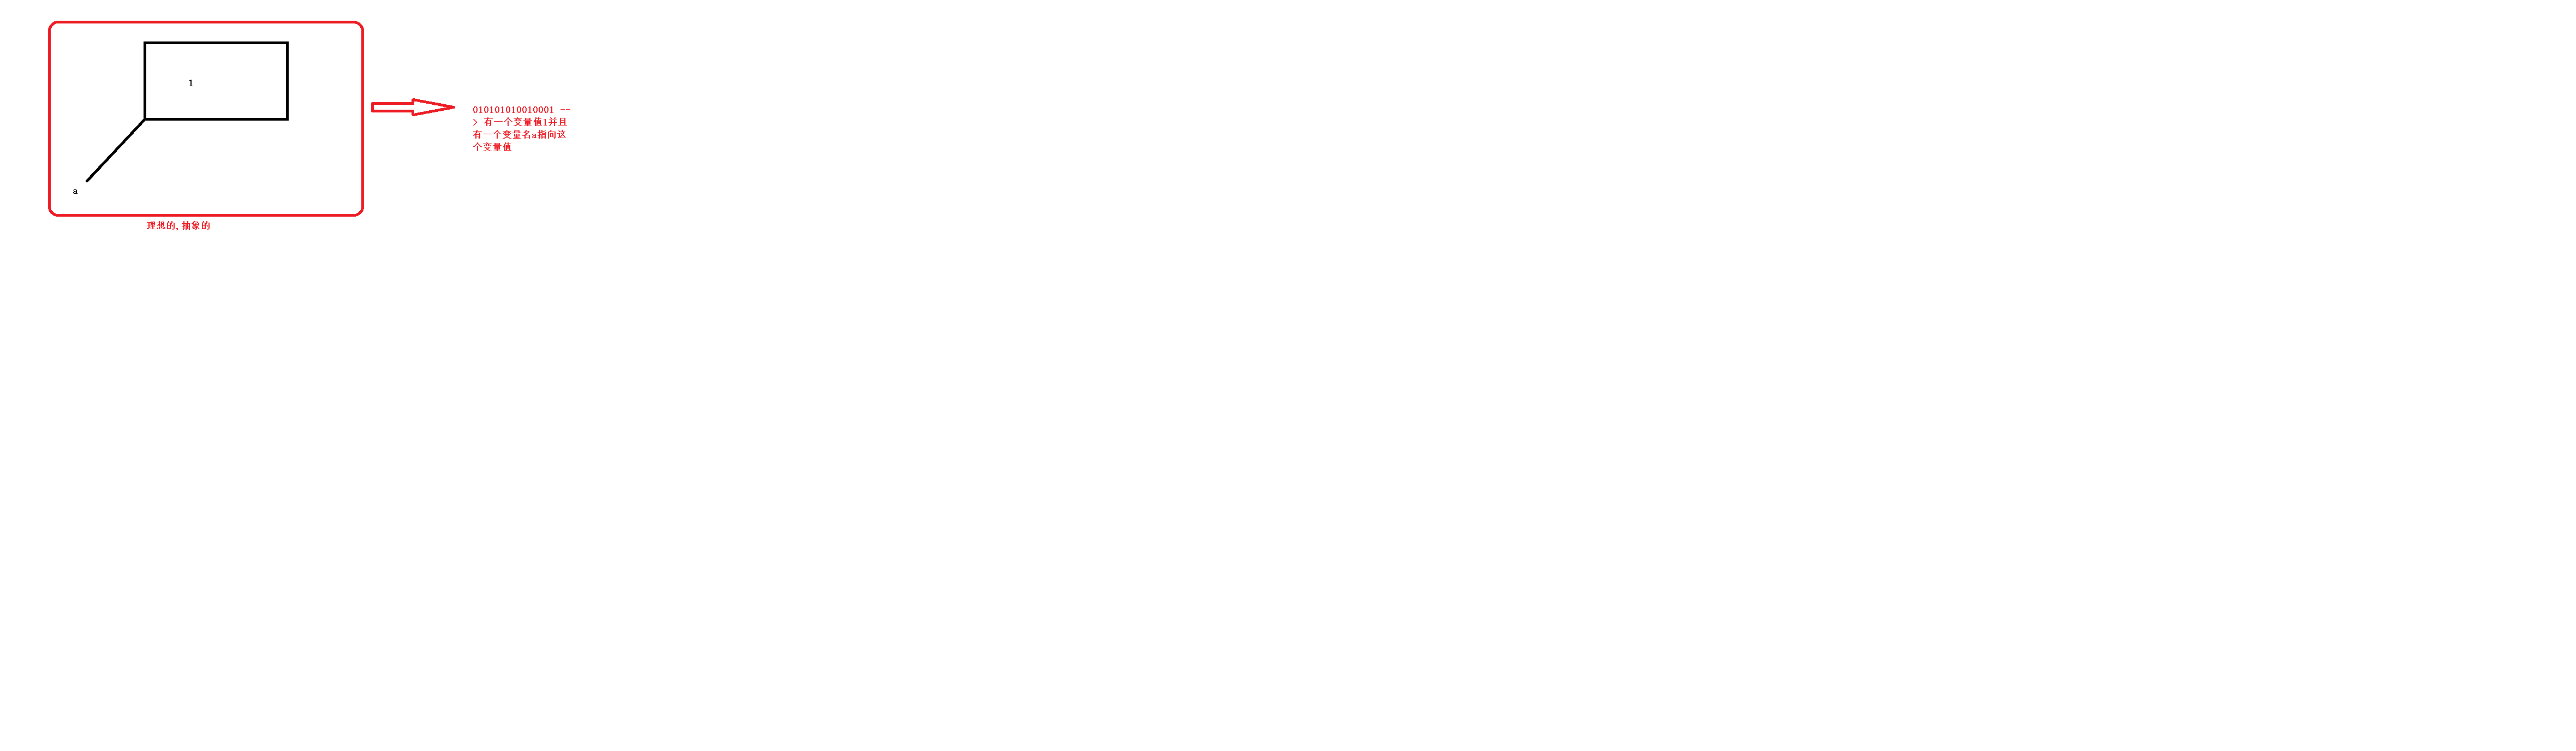
python解释器运行代码的流程启动python解释器(相当于文本编辑器)打开文件,显示这个字符并检查语法(涉及字符编码, a=1只是一个很普通的字符)解释字符 (涉及字符编码,再去内存空间 生成一个a=1的变量)
python2用的是ascii, python3默认是utf8读取字符
# coding:gbk会告诉python3解释器用gbk编码读取字符
python3(了解)
你看到的其实是unicode
但是终端帮你把这个unicode的0和1做一个转换,从unicode转换成了终端能够识别的编码格式,然后变成中文
# coding:gbk
a = '中文' # 用unicode编码存储了这堆0和1
print(a) # 010101010
假设终端的默认编码是gbk , 认识 unicode编码的变量
假设终端的默认编码是utf8,认识 unicode编码的变量
Python2(了解)
unicode + 指定的coding编码(str类型)
# coding:gbk
a = '中文' # 用gbk编码存储了这堆0和1
a = u'中文' # 用unicode编码存储了这堆0和1
print(a)
终端是一个文本编辑器,会有默认编码.
假设终端的默认编码是gbk , 认识 gbk编码的变量
假设终端的默认编码是utf8, 不认识 gbk编码的变量
总结
| 代码详情 | Python2执行情况 | Python3执行情况 |
|---|---|---|
| # coding:gbk print('中') 终端:utf8 |
乱码 | 不乱码 |
| # coding:utf8 print('中') 终端:utf8 |
不乱码 | 不乱码 |
| # coding:gbk print(u'中') 终端:utf8 |
不乱码 | 不乱码 |
| # coding:utf8 print(u'中') 终端:utf8 |
不乱码 | 不乱码 |
不乱码不乱码
在Python2中如果指定了字符编码,那么内存存取就会按照指定的字符编码去入内存。解释或去执行时就要按照指定了的字符编码去解释,否则就会乱码。 否则可以在定义变量前面加上u,这样变量就会以unicode编码存入内存。
如:
#coding:gbkname = "爸爸"
但在Python3中就不会有这样的问题,因为无论你指定了什么字符编码,在内存存取时都会使用Unicode编码去入内存Unicode编码可以和任意的字符编码相互转换,并在读取时按照所需的编码区读取,这样就很好解决了字符编码的问题
以上就是相关的全部内容知识点,感谢大家对【听图阁-专注于Python设计】的支持。